REX: Intégration de Jev dans un agent Genkit
Par ALEXANDRE DERGHAM · 2026-11-09
Les LLM traditionnels excellent pour rédiger des e-mails, coder des fonctionnalités ou converser de manière fluide. Mais que se passe-t-il lorsque votre agent a simplement besoin de prendre une décision binaire, de classifier une intention ou de router un flux de données en une fraction de seconde ? Cet article propose une solution à cette problématique en intégrant Jev de Typesafe AI dans la structure d'un agent (en l'occurence construit en Genkit).
Tags : Jev, Genkit, Gemini
Repenser l'IA pour les machines, pas pour les humains
Le problème actuel est bien connu des développeurs : forcer un modèle génératif textuel à cracher du JSON strict alourdit considérablement le code, augmente la latence de manière inacceptable et fait grimper la facture cloud inutilement.
C'est là qu'intervient Jev (développé par TypeSafe AI), un modèle de type System One conçu exclusivement pour renvoyer des décisions typées et des probabilités au lieu de blocs de texte brut. Dans cet article, découvrez comment l'intégrer proprement au sein d'un agent Genkit pour créer un système de décision à la fois robuste, ultra-rapide et économique.
Qu'est-ce que Jev de TypeSafe AI et en quoi change-t-il la donne ?
Le concept "System One"
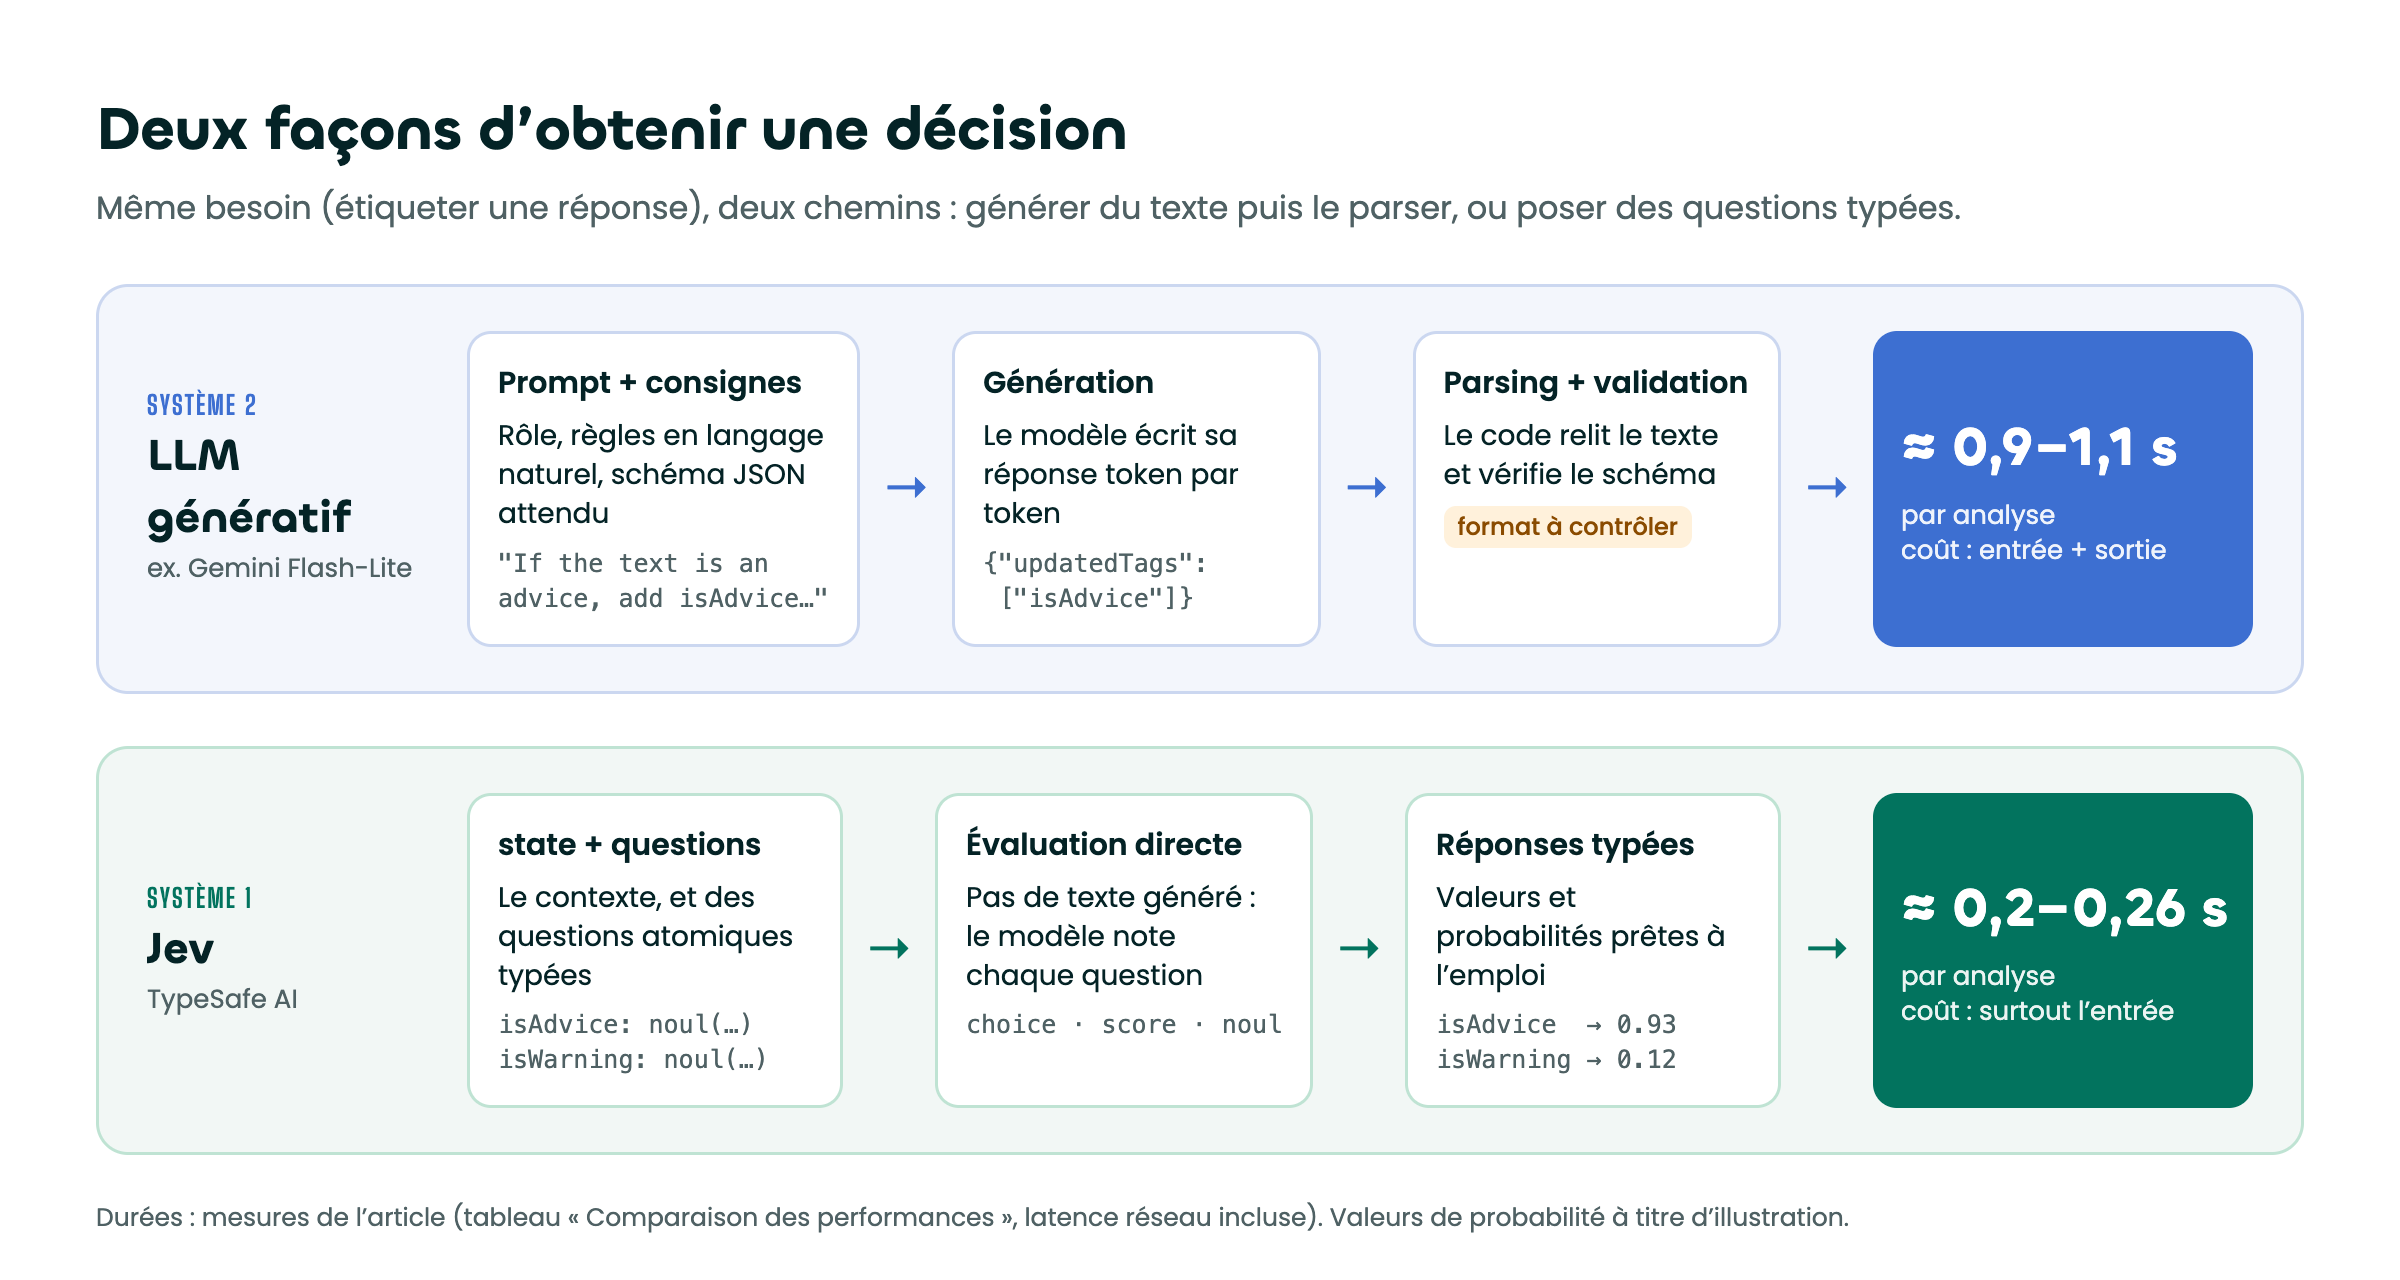
Inspiré de la psychologie cognitive de Daniel Kahneman (la pensée rapide et intuitive face à la pensée lente et analytique), Jev est taillé pour l'intuition instantanée et les jugements ciblés.
Une interface taillée pour le code
Contrairement aux LLM classiques, Jev oublie la génération de texte :
- Entrée : Un état (
state) textuel ou JSON définissant le contexte à évaluer combiné à desquestionsatomiques. - Sortie : Des données structurées, des scores précis et des distributions de probabilités.
Les trois types de questions fondamentales
Jev structure vos requêtes autour de trois primitives logiques essentielles :
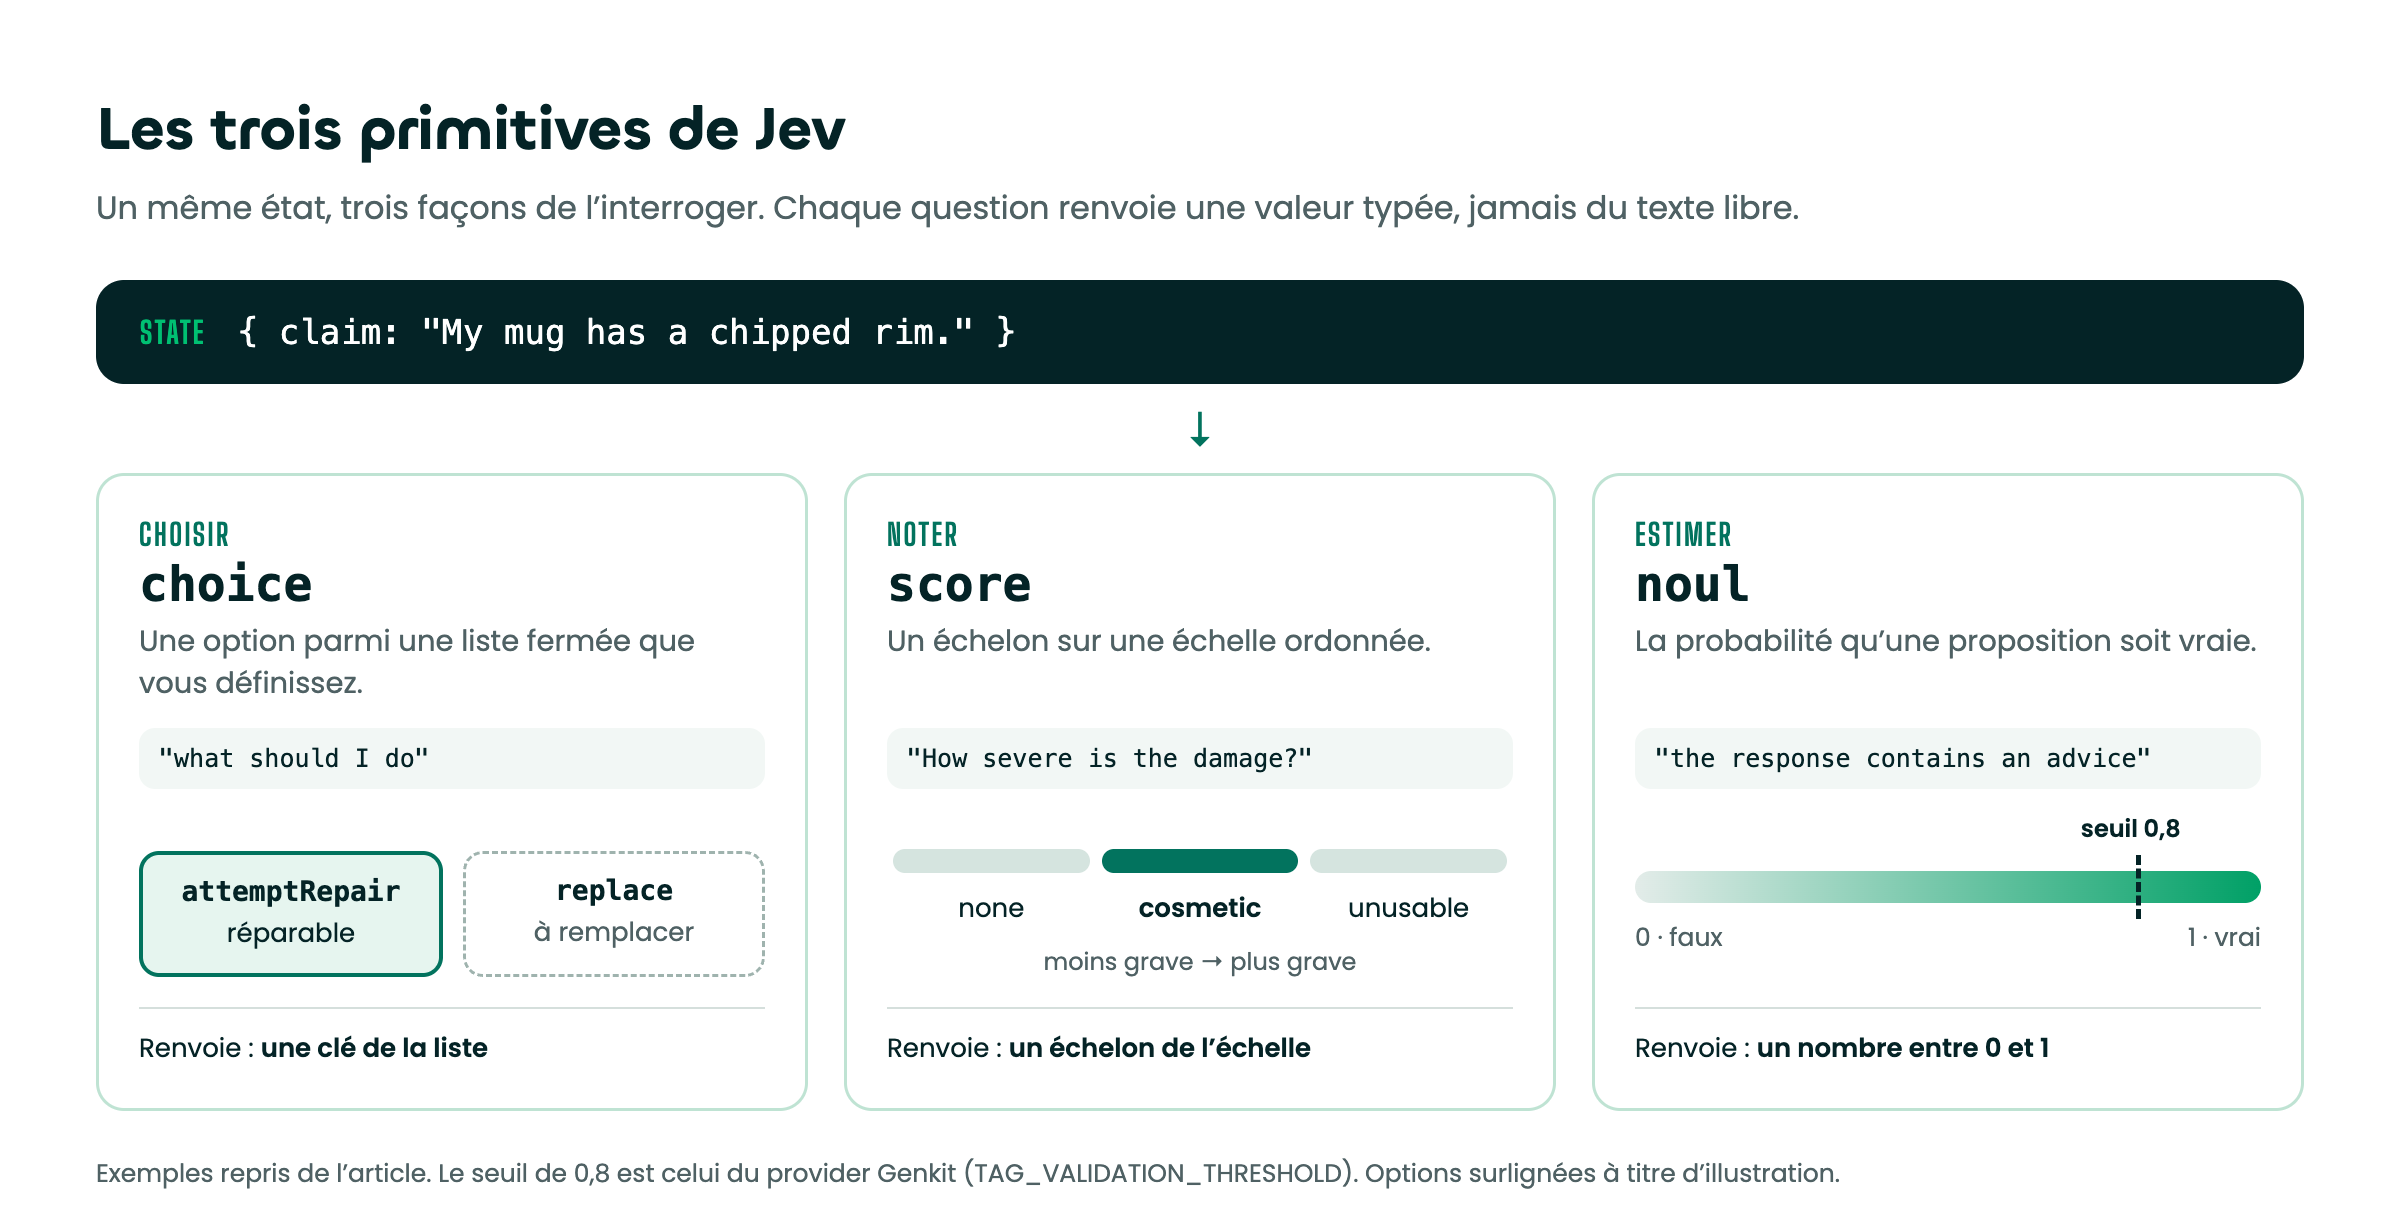
exemples en typescript avec @typesafe-ai/sdk:
state: { claim: "My mug has a chipped rim." },
questions: {
  // retourne "attemptRepair" ou "replace" selon la réparabilité du produit
  action: choice("what should I do", {
    attemptRepair: "the product can be repaired",
    replace: "the product cannot be repaired"
  }),

  // retourne "none", "cosmetic" ou "unusable"
  // en fonction des dégats subits par le produit
  severity: score("How severe is the damage?", [
    "none",
    "cosmetic",
    "unusable"
  ]),

  // retourne un nombre entre 0 et 1,
  // 0 indique que le produit est parfaitement utilisable
  // 1 indique que le produit est inutilisable avec 100% de certitude
  damaged: noul("Is the product still usable")
},
Les avantages clés
Grâce à cette approche spécialisée, Jev offre des performances 40x à 200x plus rapides et nettement moins coûteuses que les LLM de pointe sur des tâches de classification, de filtrage ou de routage.
Pourquoi marier Genkit et Jev dans une architecture d'agent ?
Rappel sur Genkit
Développé par Firebase, Genkit est le framework open-source idéal pour orchestrer des agents et des workflows IA de manière modulaire, typée et sécurisée en TypeScript.
Le rôle de Jev dans une boucle d'agent
Dans une architecture moderne :
- Genkit gère le state, l'orchestration globale des outils et la génération de contenu (via Gemini, par exemple).
- Jev agit comme le moteur de décision et de routage instantané au sein de l'agent (ex. : classifier l'intention d'un utilisateur, valider une règle métier à la volée, ou router un ticket de support).
Le cas d'usage fil rouge
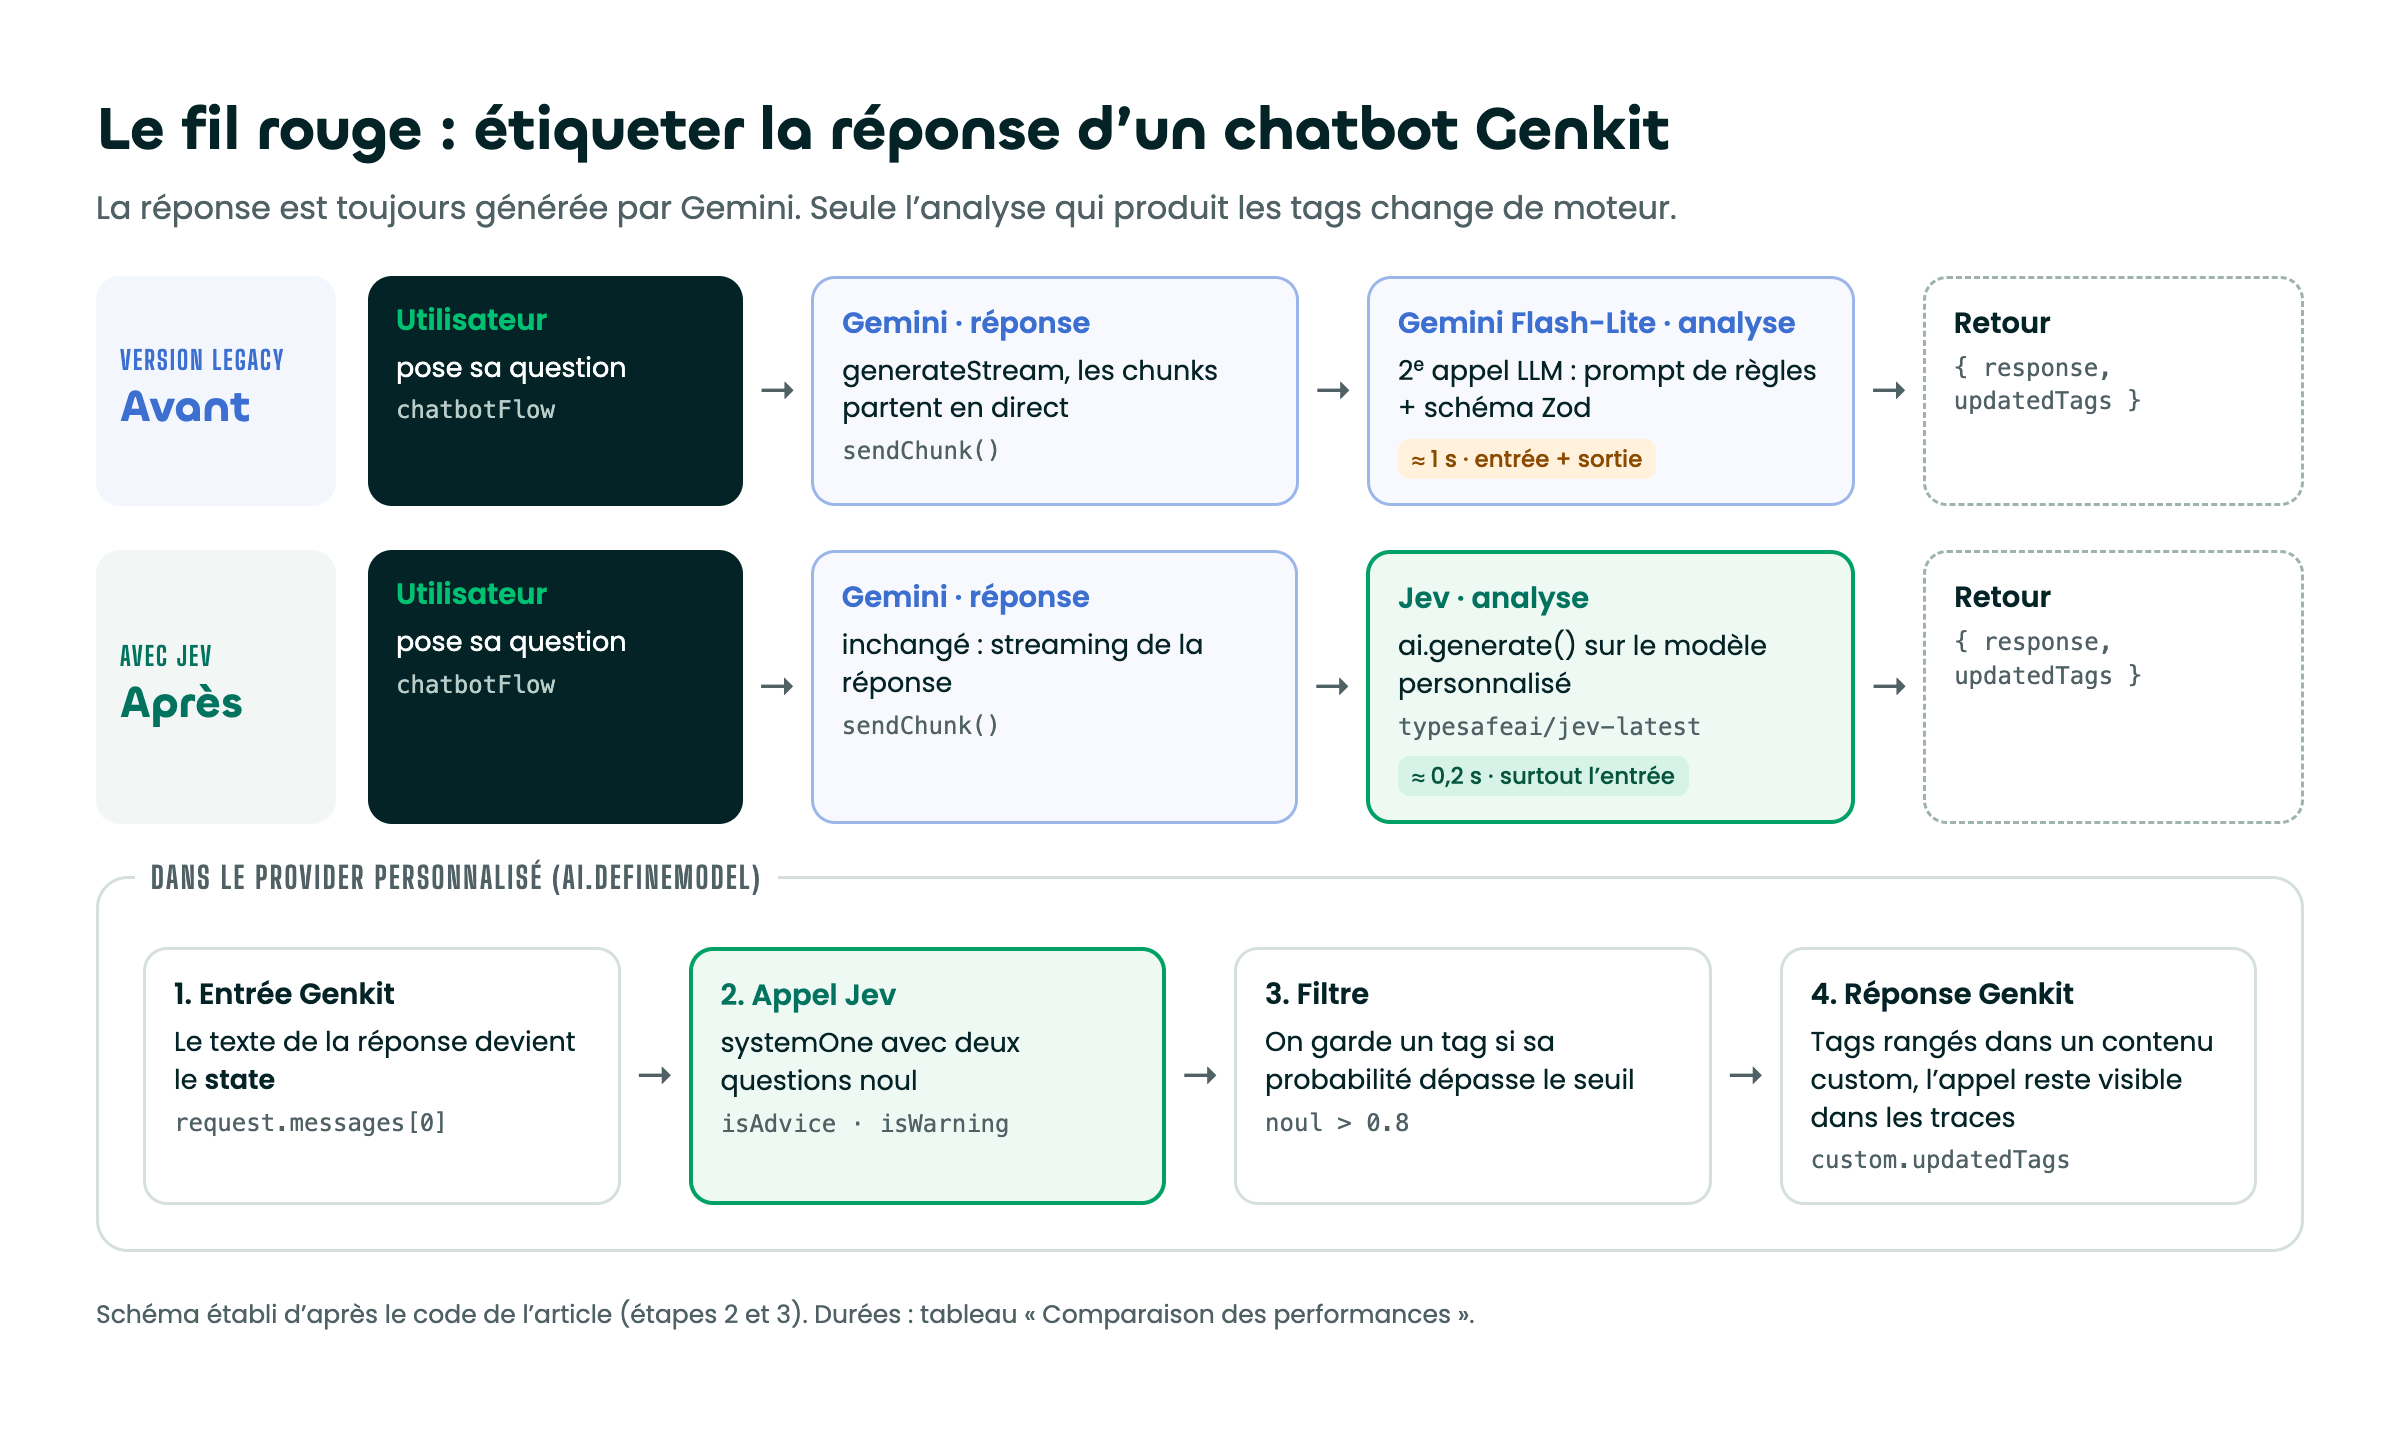
Imaginons un agent de chatbot basé sur Genkit : la réponse textuelle est générée par un LLM standard. Le besoin est de compléter cet agent de manière à ce qu'une analyse de la réponse du chat nous permette de définir une liste de tags catégoriels.
Dans la version legacy de ce chatbot, nous utilisons un prompt généré par la fonction suivante pour évaluer les tags à retenir:
export const generateTagsAnalyserPrompt =
  (chatBotResponse: string): GenerateOptions => ({
      model: 'googleai/gemini-3.5-flash-lite',
      prompt: `You are a text analyser.
        You have to check if the following text matches the following conditions
          - If the text is an advice then add "isAdvice" to the list of updated tags.
          - If the text contains a warning then add "isWarning" to the list of updated tags.
        The text to analyse is "${chatBotResponse}"`,
      config: {
        temperature: 0.2,
        topK: 20,
        topP: 0.90
      },
      output: {
        schema: z.object({
          updatedTags: z.array(z.string())
        })
      }
    });
Dans la version que nous allons écrire, la réponse sera analysée par Jev pour retourner la liste de tags.
Tutoriel pas à pas : Intégrer Jev dans un agent Genkit
Étape 1 : Initialisation et configuration
Commencez par installer les dépendances nécessaires dans votre projet Node.js/TypeScript, puis configurez votre clé API sur la console de Typesafe AI :
npm install @typesafe-ai/sdk
export TYPESAFE_API_KEY="votre_cle_api"
Étape 2 : Création d'un provider personnalisé Genkit
À l'heure où j'écris cet article, il n'existe pas de plugin Genkit facilitant l'intégration de Jev en typescript donc nous allons écrire nous même le provider et le faire passer pour un model de LLM.
Notez que cette étape n'est pas obligatoire pour faire fonctionner un appel à API de Typesafe AI. Elle permet juste d'intégrer cet appel dans le framework de manière à ce qu'il apparaisse dans l'outillage de monitoring et de debugage de Genkit.
import { googleAI } from '@genkit-ai/google-genai';
import { noul, TypeSafeClient } from '@typesafe-ai/sdk';
import { GenerationCommonConfigSchema, genkit, z } from 'genkit';

const ai = genkit({
  plugins: [
    googleAI()
  ]
});

const typeSafeClient = new TypeSafeClient({ defaultModel: 'jev-latest' });
const TAG_VALIDATION_THRESHOLD = 0.8;

// Définition du modèle personnalisé
const typesafeAIModel = ai.defineModel(
  {
    name: 'typesafeai/jev-latest',
    configSchema: GenerationCommonConfigSchema,
    supports: {
      tools: false,
      systemRole: true
    }
  },
  async (request) => {
    const response = await typeSafeClient.systemOne({
      state: request.messages[0].content[0].text ?? '',
      questions: {
        isAdvice: noul('the response contains an advice'),
        isWarning: noul('the response contains a warning')
      }
    });

    const updatedTags = ['isAdvice', 'isWarning'].filter((tag) => {
      const answer = response.answers[tag];
      return answer.type === 'noul' && answer.noul > TAG_VALIDATION_THRESHOLD;
    });

    // format de réponse à respecter pour que Genkit puisse encapsuler l'appel
    return {
      message: {
        role: 'model' as const,
        content: [{ text: '', custom: { updatedTags } }]
      }
    };
  }
 );
Étape 3 : Implémentation du Flow Genkit
Voici comment structurer un Flow Genkit en TypeScript qui combine la génération de texte classique et l'évaluation ultra-rapide de Jev :
import { GenerationCommonConfigSchema, genkit, z } from 'genkit';
import { googleAI } from '@genkit-ai/google-genai';

export const generateResponseFlow = ai.defineFlow({
  name: 'chatbotFlow',
  inputSchema: /* Schema d'input */,
  outputSchema: z.object({
    response: z.string(),
    updatedTags: z.array(z.string())
  }),
  streamSchema: z.string()
}, async (subject: ChatSubject, { sendChunk }): Promise<ChatResponse> => {
  const prompt = subject.prompt;

  // Appel de l'agent chatbot principal en streaming
  // generateChatPrompt prend en charge la génération du prompt et ne sera pas détaillé ici.
  const { response, stream } = ai.generateStream(generateChatPrompt(subject));

  for await (const chunk of stream) {
    sendChunk(chunk.text);
  }

  const chatResponse = (await response).text;

  // Appel du model JEV encapsulé
  let updatedTags = [];
  const jevResponse = await ai.generate({
    prompt: { text: chatResponse },
    model: typesafeAIModel
  });
  updatedTags = jevResponse.message?.content[0]?.custom?.updatedTags;

  return {
    response: chatResponse,
    updatedTags
  };
});
Autres cas d'usage possibles
Le mode de fonctionnement de Jev est tellement simple qu'il peut être appliqué à de nombreux cas d'usages:
- Faire respecter des guard rails en validant la réponse de sortie d'un agent (ex. absence de données sensibles dans la réponse)
- Catégoriser et trier un message en entrée pour qu'il soit traité par un agent ou un processus approprié.
- Évaluation d'un message basée sur un critère simple (ex. le niveau d'urgence d'un ticket à traiter ou risque de churn d'un client).
Notez que la fiabilité de Jev dépend quand même de la simplicité du prompt d'entrée. Jev ne pouvant pas décomposer et détailler un raisonnement, la bonne pratique consiste à définir les choix les plus simples et les atomiques possibles.
Solution alternative: Kev
Kev est une solution alternative à Jev reprenant l'approche "system one".
Cette solution basée sur Qwen peut être déployée et exécutée en local avec des performances restant intéressantes par rapport à celles d'une approche utilisant un LLM classique tant que la taille de l'input reste modeste.
Point notable: l'intégration de l'appel de Kev par l'agent Genkit est grandement facilitée par la lib @typesafe-ai/sdk où la seule modification à apporter se trouve au niveau de l'initialisation du typeSafeClient.
const typeSafeClient = new TypeSafeClient({
    defaultModel: 'kev-latest',
    apiKey: 'local',
    baseURL: 'http://localhost:8009'
  });
Comparaison des performances
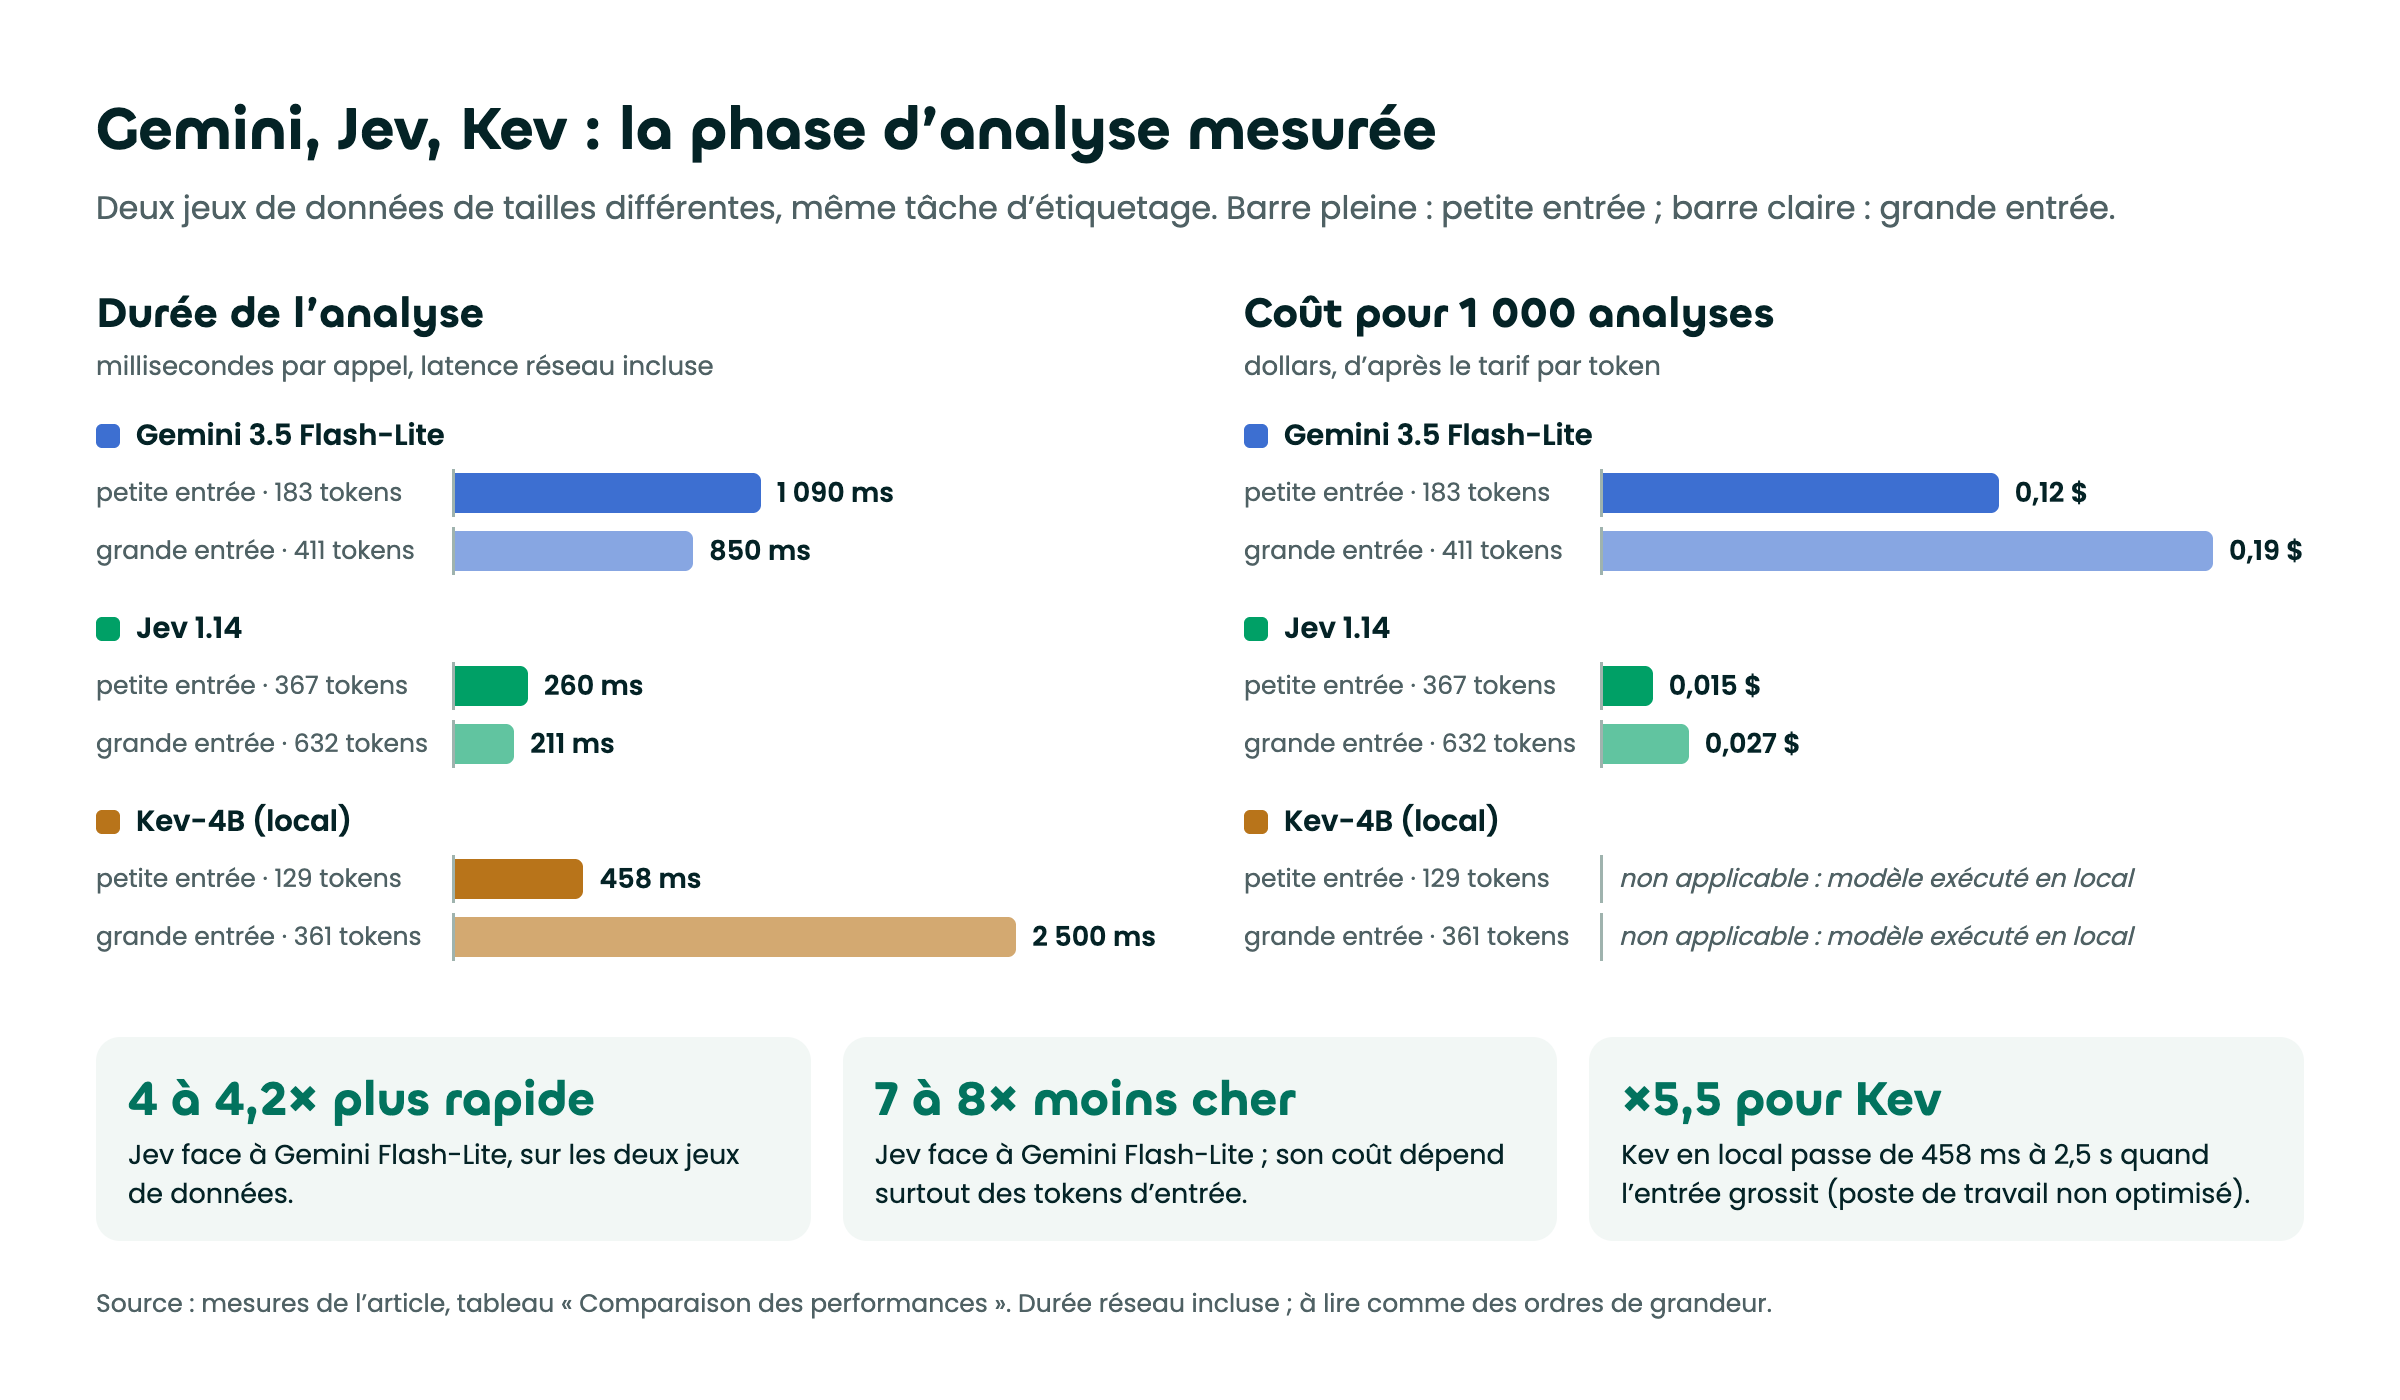
En utilisant 2 séries de jeux de données de tailles différentes, nous avons comparé la durée et le coût de traitement de la phase d'analyse (incluant la latence réseau).
En résumer, nous pouvons observer que
- Les durées de traitement de Gemini et Jev restent stable même lorsque la taille de l'input augmente.
- Les performances de Kev s'effondrent lorsque la taille de l'input augmente. Cette observation reste à prendre avec circonspection dans la mesure ou le model est hébergé en local sur un poste de travail qui n'est peut-être pas optimisé pour ce type d'opération.
- Jev reste plus rapide et moins couteux que Gemini.
Notez que contrairement au models de types LLM, l'essentiel du coût de fonctionnement de Jev est basé uniquement sur le nombre de tokens en entrée.
Conclusion
En associant la flexibilité d'orchestration de Genkit à la puissance chirurgicale et instantanée de Jev (TypeSafe AI), vous éliminez les goulots d'étranglement liés à la génération de texte pour le routage. Vos agents deviennent non seulement plus rapides et moins coûteux mais gagnent aussi en fiabilité car le fonctionnement de Jev est déterministe par nature.
Prêt à tester l'approche System One dans votre prochaine application Genkit ? Partagez vos retours d'expérience en commentaire !
Pour aller plus loin
- le site officiel de Typesafe AI
- la console typesafe AI
- le site officiel de genkit
- alternative self-hostable à Jev: Kev