MCP est devenu sans état — l'état, lui, a changé d'adresse
Par THOMAS FOUTREIN · 2026-10-06
La révision 2026-07-28 du Model Context Protocol supprime les sessions, le handshake et l'en-tête Mcp-Session-Id. Trois pages plus loin, la même spécification écrit « the MCP server must be stateful ». Lecture d'architecte : ce que le protocole retire vraiment, et les trois endroits où l'état réapparaît aussitôt.
Tags : MCP, protocoles ouverts, architecture, IA agentique, stateless, standards IA
La spécification du Model Context Protocol écrit désormais, en toutes lettres, dans une section normative intitulée « Statelessness » (🌐 absence d'état) :
The Model Context Protocol (MCP) is a stateless protocol: all the information needed to process a request is contained in the request itself.
🌐 Le Model Context Protocol est un protocole sans état : toute l'information nécessaire au traitement d'une requête est contenue dans la requête elle-même.
Trois pages plus loin, la même spécification écrit, à propos de l'élicitation en mode URL :
The MCP server is responsible for storing and managing the third-party tokens obtained through the URL mode elicitation (in other words, the MCP server must be stateful).
🌐 Le serveur MCP est responsable du stockage et de la gestion des jetons tiers obtenus par l'élicitation en mode URL (autrement dit, le serveur MCP doit être à état).
Les deux phrases sont exactes. Et c'est tout le sujet de cet article.
La révision 2026-07-28, publiée le 28 juillet 2026, est la plus brutale de l'histoire de MCP. Elle ne rend pas le sans-état possible : il l'était déjà. Elle le rend obligatoire. Ce qui est une décision d'architecture, pas une option de configuration. Et comme toute décision d'architecture, elle ne fait pas disparaître la complexité : elle la déplace. Voici où.
D'abord, une correction : le sans-état n'est pas nouveau
Le récit ambiant veut que MCP « devienne enfin sans état ». C'est faux, et il faut le dire pour comprendre ce qui change réellement.
Un serveur MCP HTTP sans session était possible depuis la révision 2025-03-26. Le texte de l'époque disait : « A server using the Streamable HTTP transport MAY assign a session ID at initialization time. » (🌐 un serveur utilisant le transport Streamable HTTP peut attribuer un identifiant de session au moment de l'initialisation) Un MAY, donc une faculté. Et côté implémentation, la proposition SEP-2567 le reconnaît sans détour : « All official SDKs except PHP already provide a stateless mode » (🌐 tous les SDK officiels sauf PHP proposent déjà un mode sans état), avec sessionIdGenerator: undefined côté TypeScript et stateless_http=True côté Python.
Ceux qui en avaient besoin ne l'ont pas attendu. Cloudflare a fait tourner son serveur MCP Code Mode en mode sans état non officiel dès février 2026 : « it has scaled up to thousands of requests per second and served billions of tool calls » (🌐 il est monté à des milliers de requêtes par seconde et a servi des milliards d'appels d'outils). GitHub a migré cinq jours avant la publication de la spécification finale, en supprimant au passage ses sessions Redis : « Database writes on initialize are gone, and database reads are gone from every call. » (🌐 les écritures en base sur initialize ont disparu, et les lectures en base ont disparu de chaque appel)
Ce que 2026-07-28 apporte n'est donc pas une capacité, c'est une garantie. Et cette garantie débloque quelque chose que le mode facultatif ne débloquait pas. L'argument est dans SEP-2567, et il est plus subtil qu'il n'y paraît : pour un orchestrateur qui lance des sous-agents, « the O(subagents × servers) cost is caused by sessions being possible, not by sessions being used » (🌐 le coût en O(sous-agents × serveurs) tient au fait que les sessions soient possibles, pas au fait qu'elles soient utilisées). Tant qu'un serveur pouvait être à session, aucun client ne pouvait mettre en cache la liste de ses outils. Rendre le sans-état facultatif n'aurait rien réglé.
C'est pourquoi l'alternative évidente, garder le handshake et le rendre optionnel, a été examinée puis explicitement rejetée par SEP-2575 :
Supporting two parallel interaction models would have dramatically increased the complexity of the protocol and every implementation. […] It also violates the design principle of having one clear, obvious way to perform a core function.
🌐 Prendre en charge deux modèles d'interaction parallèles aurait considérablement accru la complexité du protocole et de chaque implémentation. […] Cela viole aussi le principe de conception voulant qu'il existe une seule manière claire et évidente d'accomplir une fonction fondamentale.
La formulation juste n'est donc pas « MCP a gagné le droit d'être sans état ». C'est : MCP a perdu le droit de ne pas l'être.
La règle, et ce qu'elle interdit
Le cœur normatif tient en deux phrases :
A server processes each request independently; no state should be inferred from previous requests, even those on the same connection or stream.
🌐 Un serveur traite chaque requête indépendamment ; aucun état ne doit être déduit des requêtes précédentes, même de celles passées sur la même connexion ou le même flux.
Servers MUST NOT rely on prior requests over the same connection to establish context (e.g., capabilities, protocol version, client identity). Every request supplies this metadata in its
_metafield.
🌐 Les serveurs ne doivent pas s'appuyer sur les requêtes antérieures passées sur la même connexion pour établir le contexte (capacités, version du protocole, identité du client). Chaque requête fournit ces métadonnées dans son champ _meta.
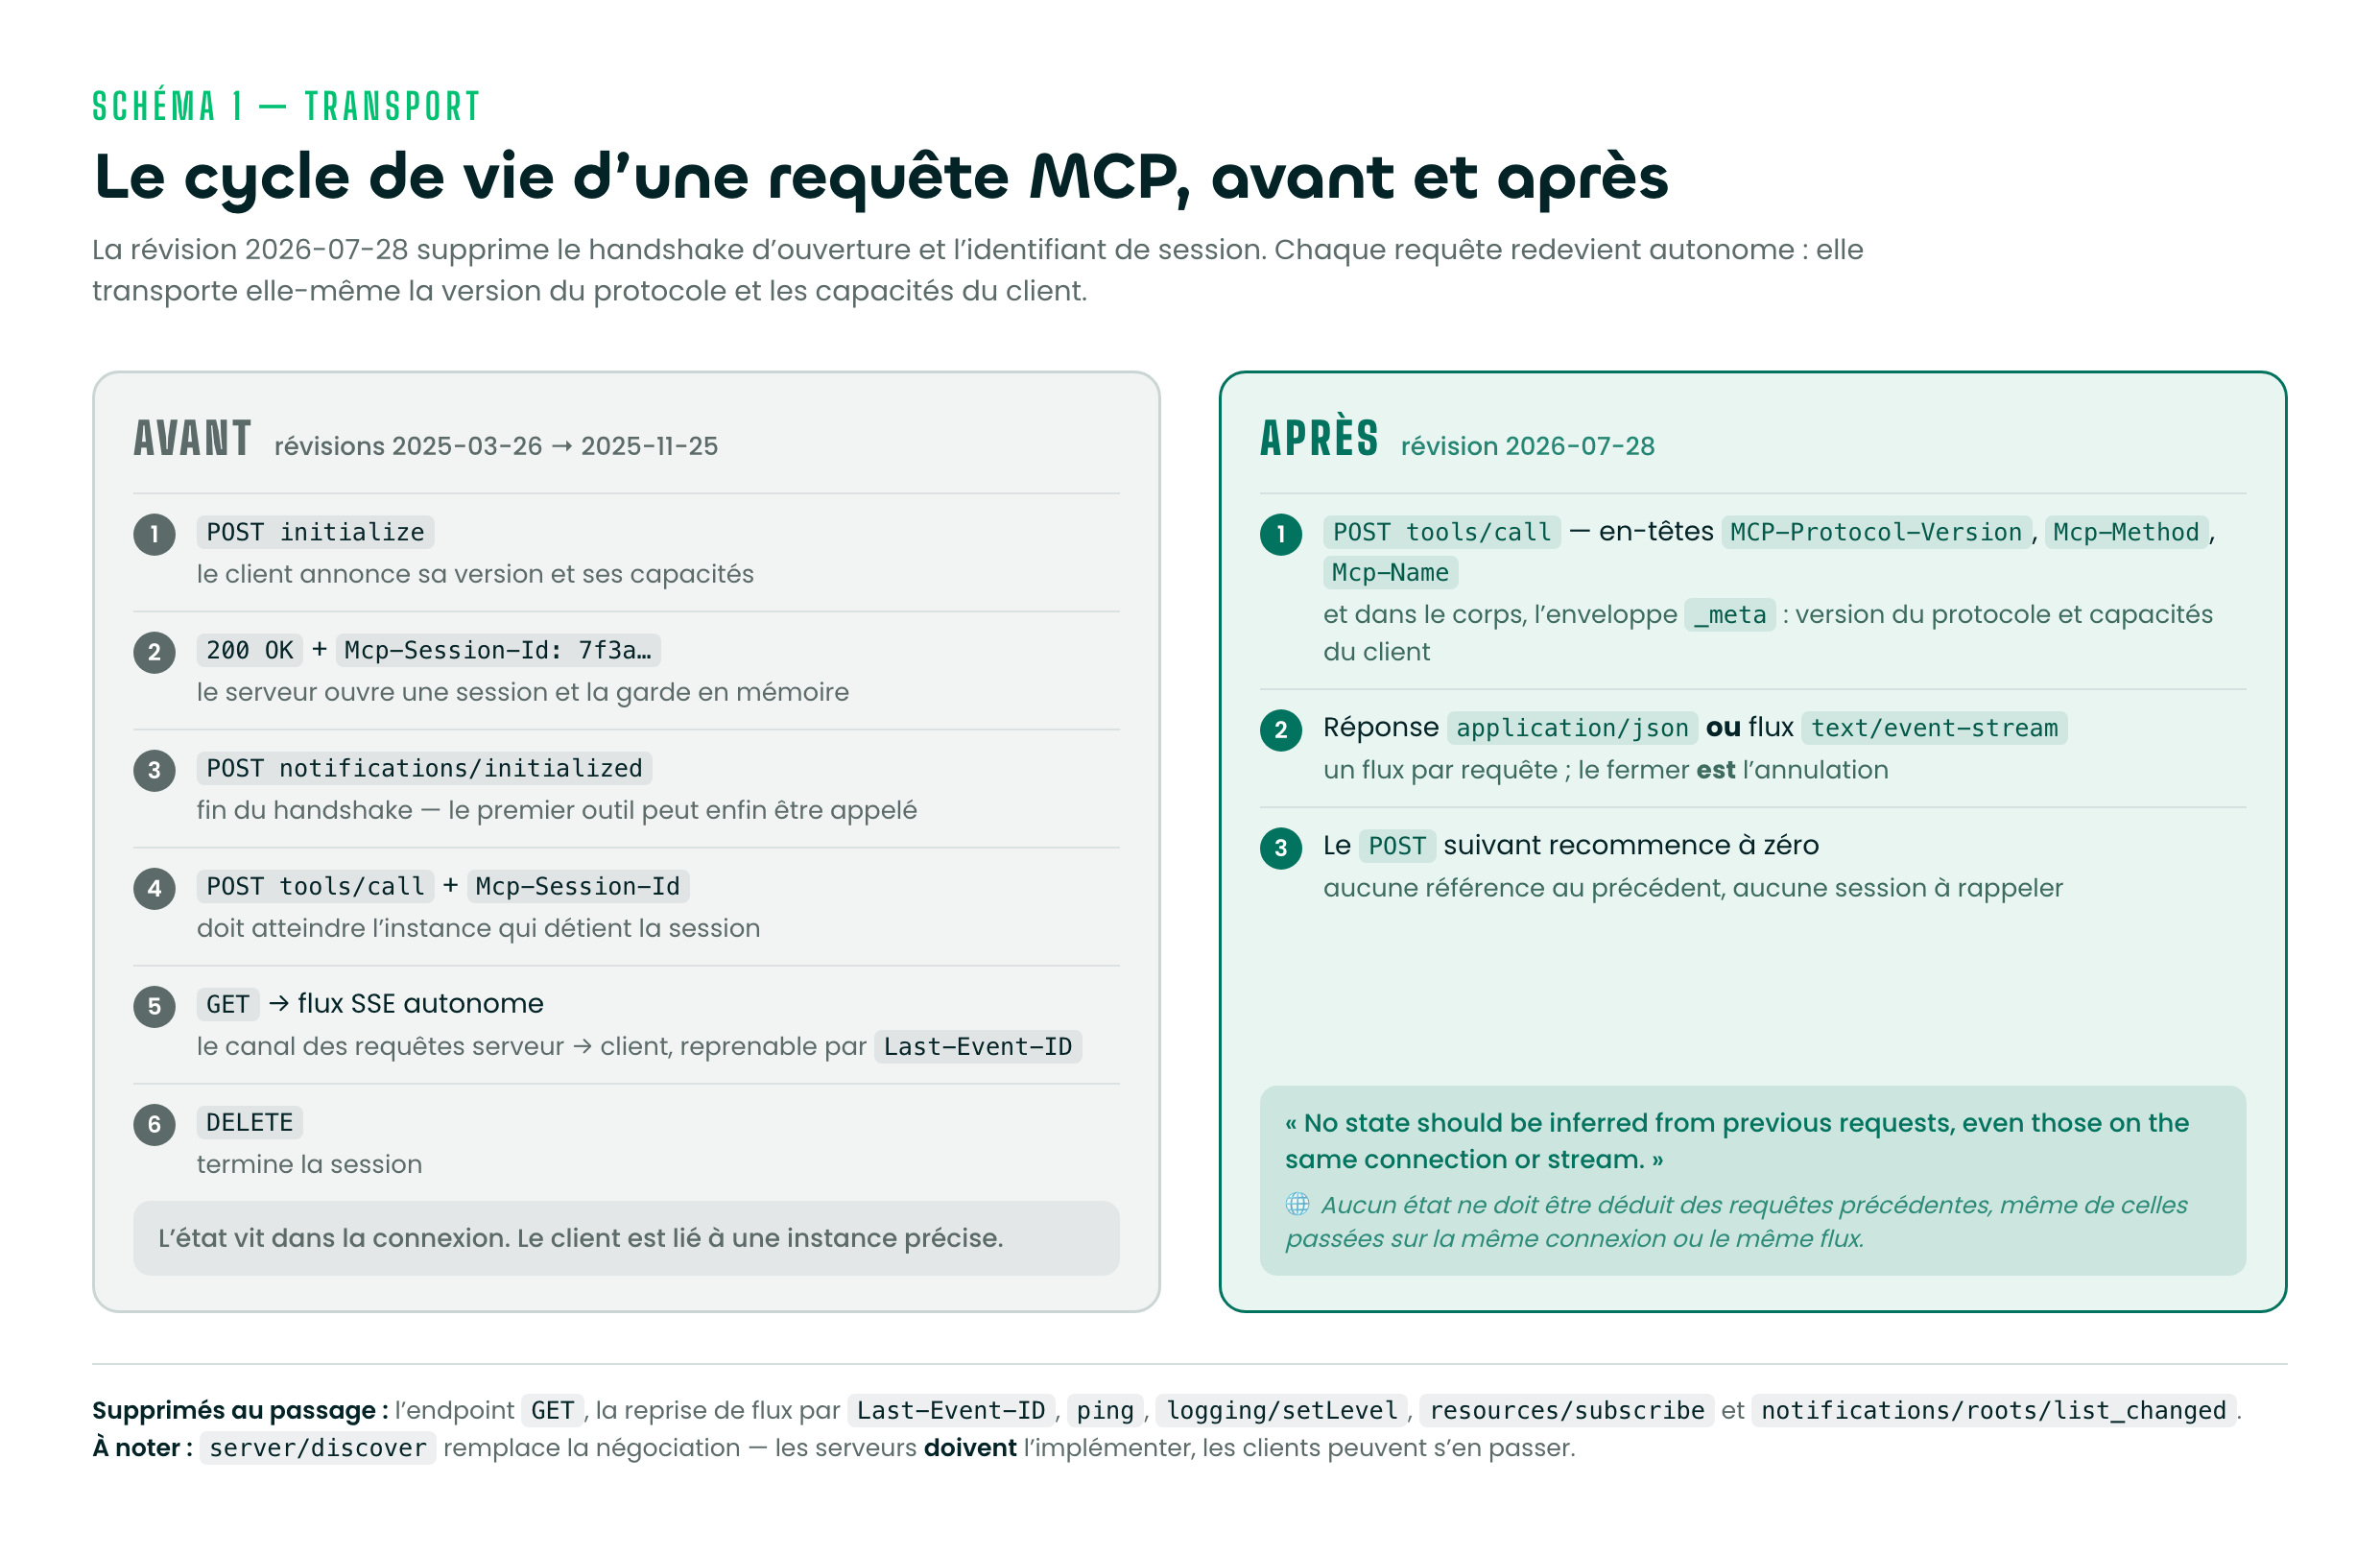
Concrètement, disparaissent du protocole : le handshake initialize / notifications/initialized, l'en-tête Mcp-Session-Id, l'endpoint GET, la reprise de flux par Last-Event-ID, ping, logging/setLevel, resources/subscribe et notifications/roots/list_changed. Et Roots, Sampling, Logging ainsi que l'enregistrement dynamique de client (DCR) passent au statut déprécié d'un seul coup.
En remplacement : une méthode server/discover (que les serveurs doivent implémenter, mais que les clients peuvent ignorer), une enveloppe _meta portée par chaque requête, et des en-têtes HTTP obligatoires Mcp-Method et Mcp-Name, dont la spécification justifie elle-même l'existence par le besoin des intermédiaires « to route and inspect requests without parsing the body » (🌐 pour router et inspecter les requêtes sans analyser le corps).
Un détail que beaucoup d'articles se trompent à durcir : dans cette enveloppe, la version de protocole et les capacités du client sont requises, mais clientInfo ne l'est pas. SEP-2575 le rendait obligatoire ; une PR ultérieure l'a rendu optionnel après finalisation.
Voici le bilan fonctionnel, sans complaisance :
| Fonction | Avant (≤ 2025-11-25) | Après (2026-07-28) |
|---|---|---|
| Négociation de version | initialize, une fois par connexion |
_meta sur chaque requête, plus server/discover |
tools/list |
Pouvait varier par connexion | « MUST NOT vary per-connection » (🌐 ne doit pas varier selon la connexion) ; seule la variation par autorisation subsiste |
| Notifications de changement | Flux GET SSE autonome | Flux de réponse d'un subscriptions/listen, avec opt-in par type |
| Abonnement aux ressources | resources/subscribe |
Champ du filtre subscriptions/listen |
| Sampling, Élicitation, Roots | Requête serveur → client | Pattern MRTR (Sampling et Roots sont dépréciés) |
Progression (progressToken) |
Notifications sur le flux | Inchangé |
| Reprise après coupure | Last-Event-ID et rejeu d'événements |
Supprimée : le client doit réémettre avec un nouvel identifiant |
| Annulation | notifications/cancelled |
En HTTP, fermer le flux est l'annulation |
| État applicatif (panier, transaction) | Porté par la session | Plus rien dans le protocole |
| Opérations longues | Session et reprise | Extension Tasks, en dehors du cœur |
La perte la plus sous-estimée est dans la deuxième ligne. Le pattern qui consistait à appeler connect_database() pour faire apparaître query et list_tables dans les tools/list suivants n'est plus permis. La révélation progressive d'outils, que beaucoup d'équipes utilisaient pour contenir la taille du contexte, sort du champ du protocole.
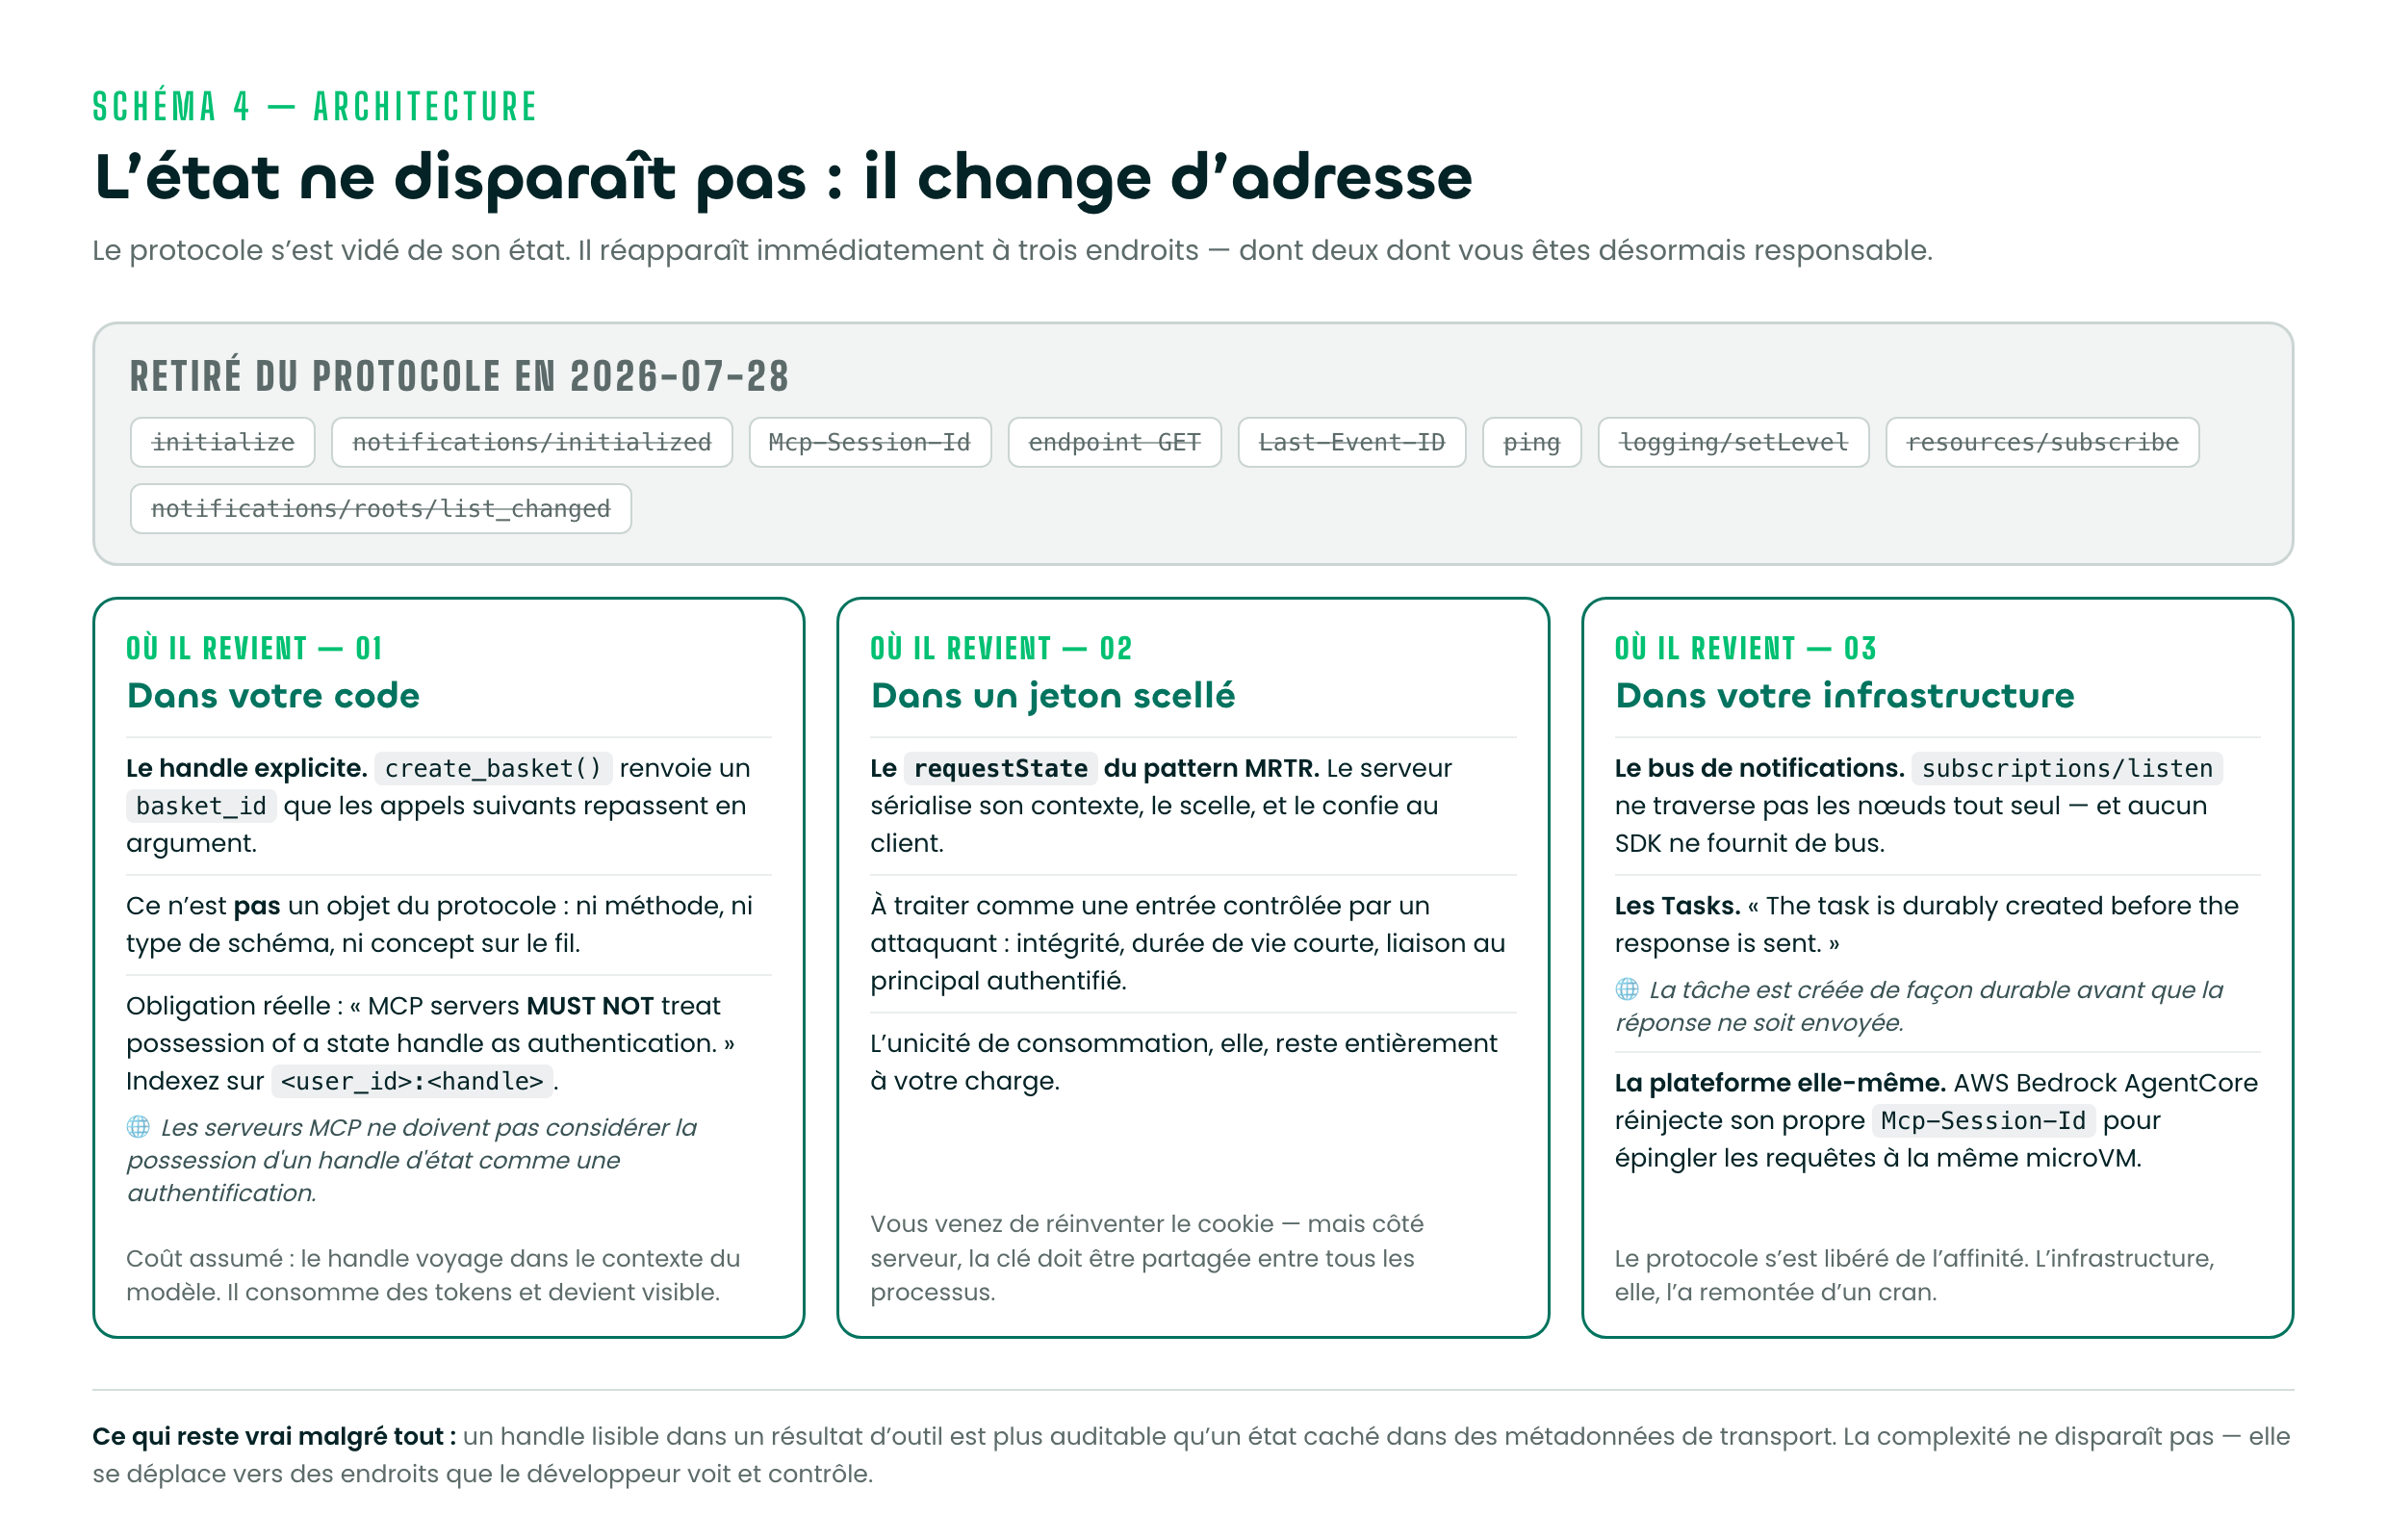
Où l'état réapparaît (1) : dans votre code
Le remplaçant officiel de la session est le handle explicite : create_basket() renvoie un basket_id, que les appels suivants passent en argument. C'est déjà, de fait, ce que font les serveurs distants déployés : Linear renvoie un identifiant d'issue, Stripe un identifiant de client, GitHub un numéro de PR.
Le point le plus mal compris est celui-ci, et SEP-2567 l'écrit noir sur blanc :
Explicit state handles are not a new protocol construct — there is no schema or wire format for them. […] There is no
handles/*method, no handle type in the schema, no wire-level concept of a handle at all.
🌐 Les handles d'état explicites ne sont pas une nouvelle construction du protocole : il n'existe pour eux ni schéma ni format sur le fil. […] Il n'y a pas de méthode handles/*, pas de type handle dans le schéma, aucun concept de handle au niveau du fil.
Autrement dit : le protocole a retiré une primitive et vous a rendu la responsabilité. La page « Tools » de la spécification traite d'ailleurs les stateful tools dans une section explicitement non normative. Ce qu'on lit parfois, « la spec impose 128 bits d'entropie sur les handles », est faux : c'est une recommandation, et elle est présentée comme telle : « This is guidance, not a protocol requirement, since the protocol has no handle concept to enforce against » (🌐 ceci est une recommandation, pas une exigence du protocole, puisque le protocole n'a aucun concept de handle sur lequel l'imposer).
Une seule obligation existe réellement, et elle est ailleurs, dans les Security Best Practices :
MCP servers MUST NOT treat possession of a state handle as authentication.
🌐 Les serveurs MCP ne doivent pas considérer la possession d'un handle d'état comme une authentification.
Avec la recommandation associée : lier le handle au principal authentifié côté serveur, « for example by keying stored state as <user_id>:<handle> where the user ID is derived from the verified token rather than supplied by the client » (🌐 par exemple en indexant l'état stocké sous <user_id>:<handle>, l'identifiant d'utilisateur étant dérivé du jeton vérifié plutôt que fourni par le client).
Il faut être honnête sur le fait que ce déplacement a des perdants. La critique la mieux argumentée vient d'un développeur sur Hacker News, whitew1994, et elle mérite d'être citée sans caricature :
I can see the engineering benefits of removing the ID field […] However, this is a regression for stateful tool calling. The workaround proposed is to have the model pass in an ID which is a waste of tokens if this could have been injected by the client.
🌐 Je vois bien les bénéfices d'ingénierie qu'il y a à supprimer le champ d'identifiant […] Mais c'est une régression pour l'appel d'outils à état. Le contournement proposé consiste à faire passer un identifiant par le modèle, ce qui gaspille des tokens alors que le client aurait pu l'injecter.
Le handle transite par le contexte du modèle. Il consomme des tokens, il peut être perdu par un compacteur de conversation, et il devient visible de tout ce qui peut influencer l'entrée du modèle. La réponse officielle est recevable (les modèles manipulent déjà couramment des chemins de fichiers, des URL et des identifiants renvoyés par des appels précédents), mais elle ne supprime pas le coût.
En contrepartie, l'argument d'expressivité est le meilleur du camp favorable, et il est réellement convaincant. Prenez un orchestrateur qui lance des sous-agents devant partager un panier mais disposer chacun de leur navigateur : s'ils partagent la session du parent, le navigateur est écrasé ; s'ils ont leur propre session, le panier est perdu. « No session boundary satisfies both. » (🌐 aucune frontière de session ne satisfait les deux à la fois) Une session offre exactement une portée par connexion ; des identifiants explicites en offrent autant que le modèle en crée.
Où l'état réapparaît (2) : dans un jeton que vous devez sceller
Les requêtes serveur → client ont disparu. Un serveur qui a besoin d'une information du client (une élicitation, une racine de système de fichiers) ne peut plus la demander sur un flux ouvert. Il doit passer par le pattern MRTR (Multi Round-Trip Requests) :
Servers MUST send server-to-client requests (such as
roots/list,sampling/createMessage, orelicitation/create) using the MRTR pattern. The previous pattern of server-initiated requests is no longer supported. This is a breaking change.
🌐 Les serveurs doivent émettre les requêtes serveur vers client (comme roots/list, sampling/createMessage ou elicitation/create) au moyen du pattern MRTR. Le précédent modèle de requêtes initiées par le serveur n'est plus pris en charge. Il s'agit d'un changement de rupture.
Le mécanisme : le serveur répond resultType: "input_required", le client collecte les réponses, puis rejoue la requête d'origine avec un identifiant JSON-RPC différent. Et comme le serveur ne garde rien entre les deux, il peut joindre à sa réponse un champ requestState : un jeton opaque, « meaningful only to the server » (🌐 qui n'a de sens que pour le serveur), que le client lui renverra tel quel.
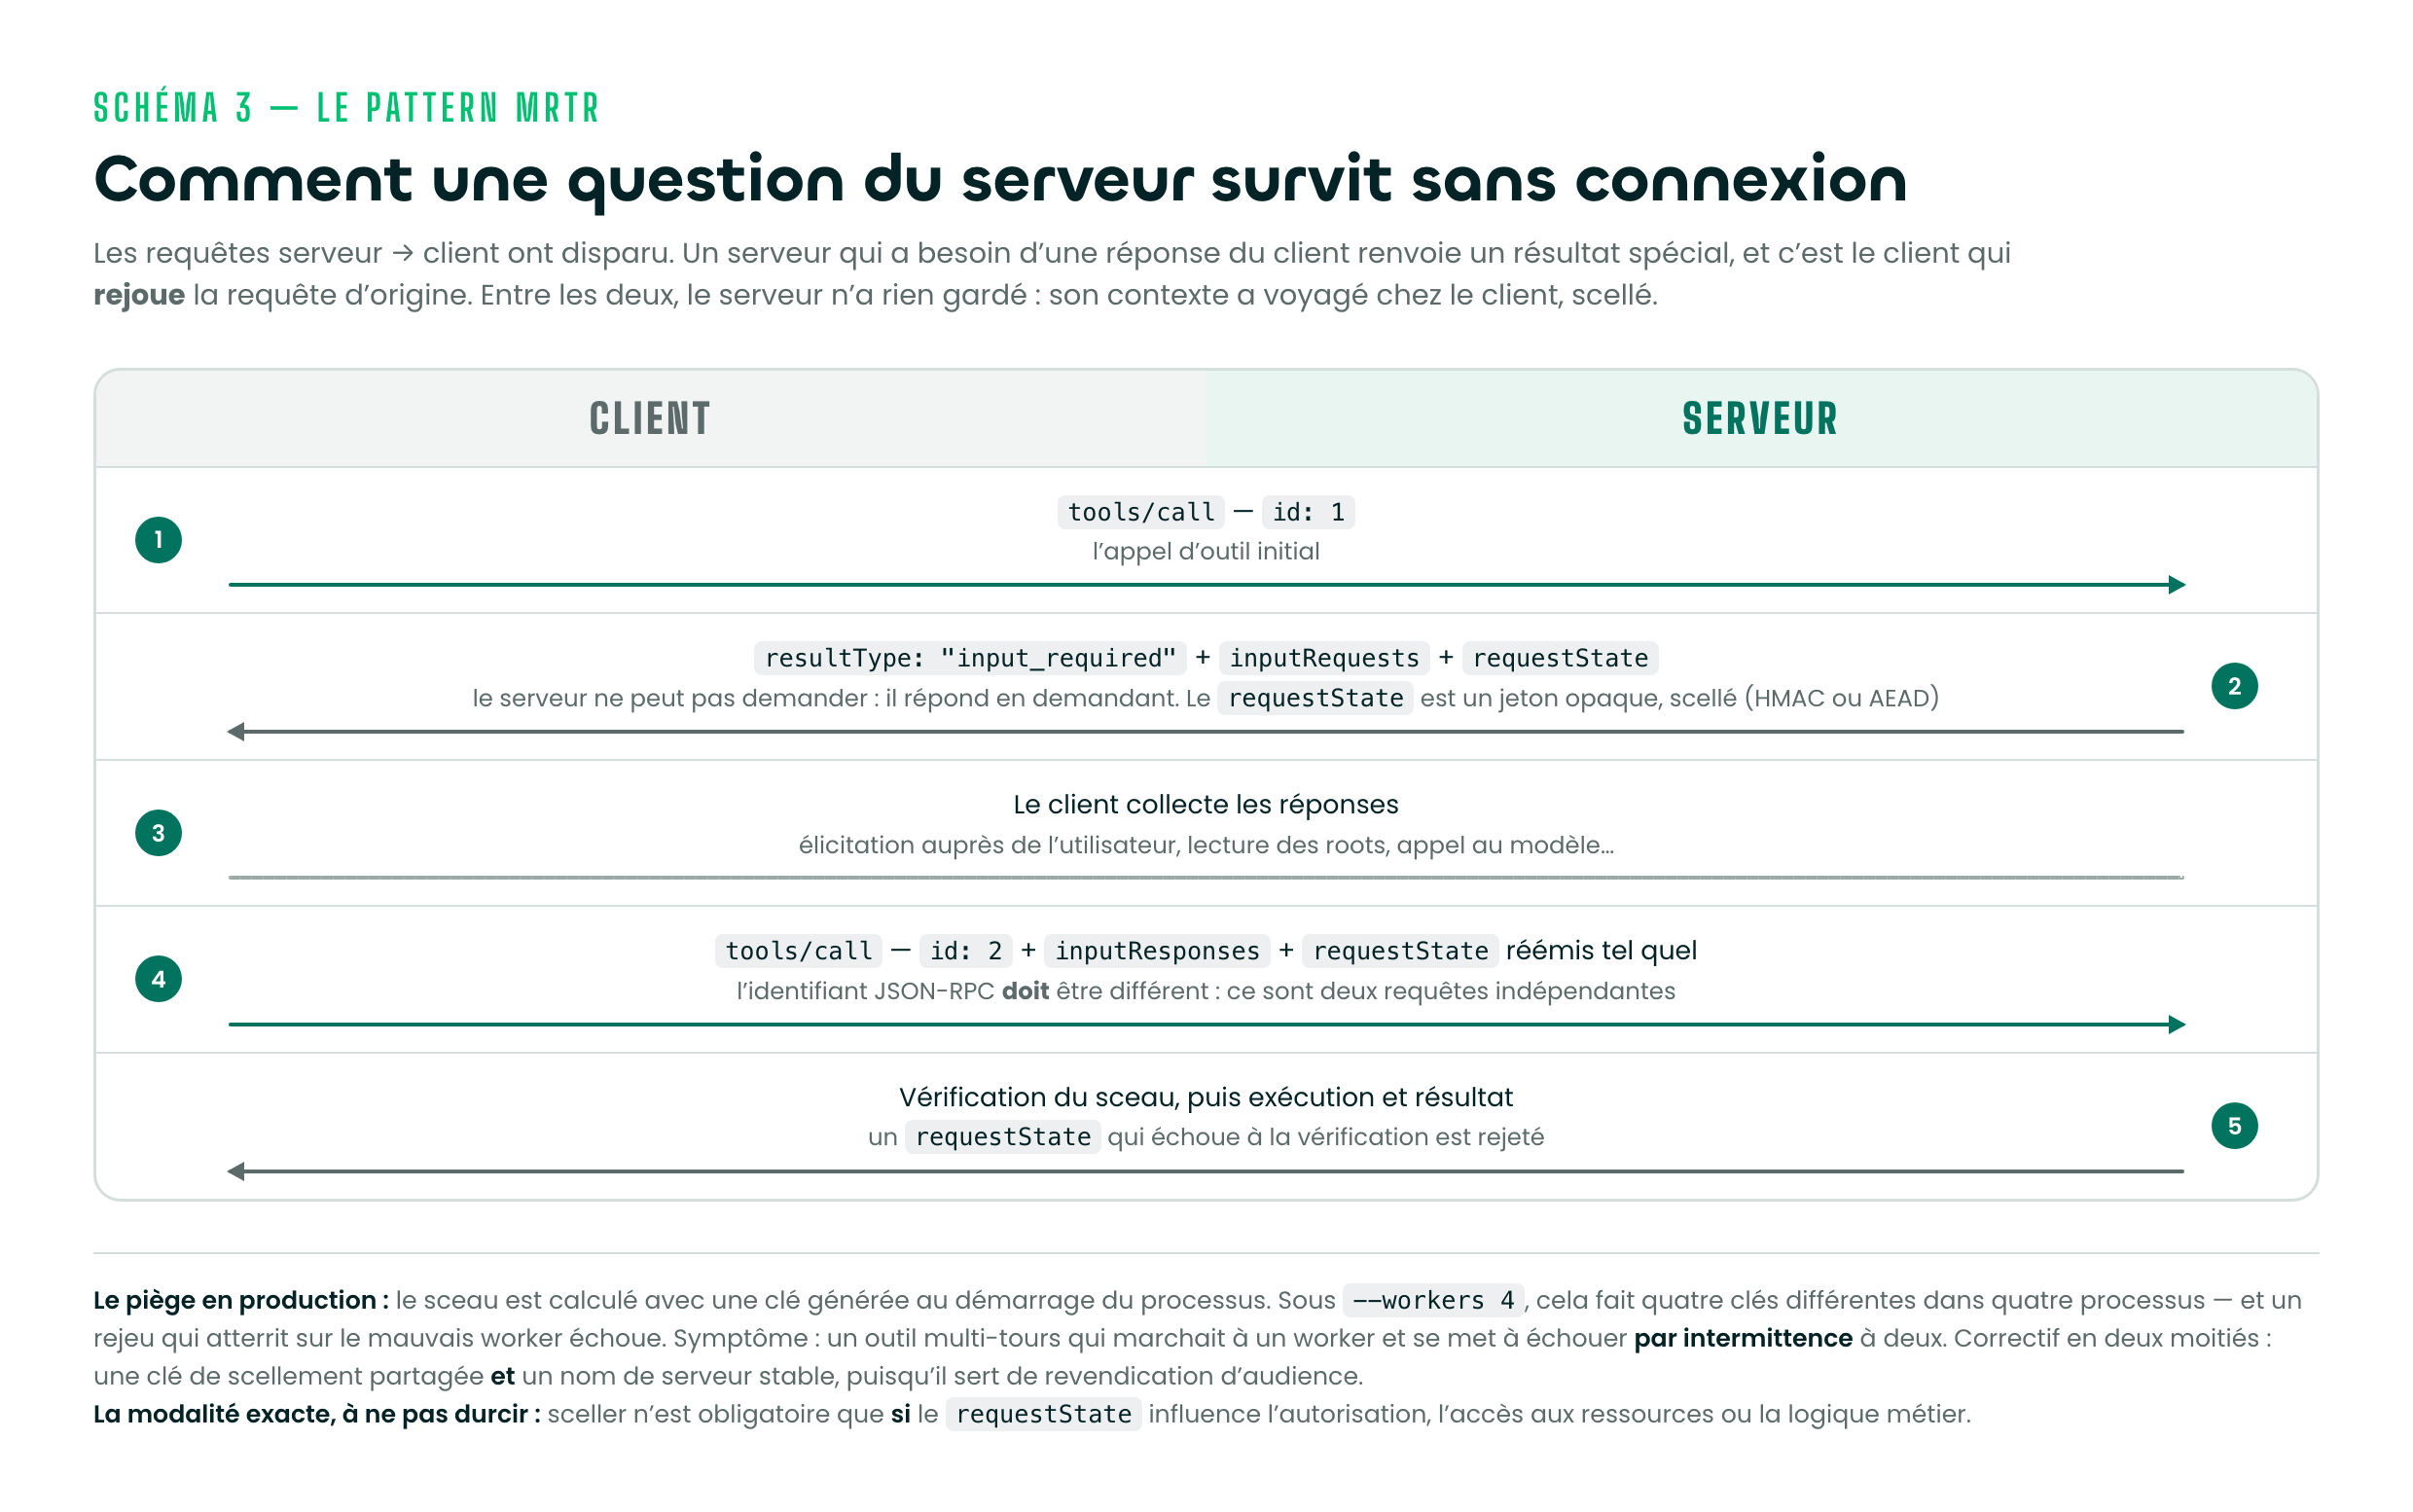
Vous venez de réinventer le cookie. À une différence près, décisive :
Servers MUST treat
requestStateas an attacker-controlled input. IfrequestStateinfluences authorization, resource access, or business logic, servers MUST protect its integrity (e.g. HMAC or AEAD) and MUST reject state that fails verification.
🌐 Les serveurs doivent traiter requestState comme une entrée contrôlée par un attaquant. Si requestState influence l'autorisation, l'accès aux ressources ou la logique métier, les serveurs doivent en protéger l'intégrité (par exemple par HMAC ou AEAD) et doivent rejeter tout état dont la vérification échoue.
Notez la modalité exacte : l'obligation de sceller est conditionnelle, et la spécification prévoit l'exemption : « Integrity protection MAY be omitted only when tampering can cause nothing worse than request failure » (🌐 la protection d'intégrité peut être omise uniquement lorsqu'une altération ne peut rien causer de pire que l'échec de la requête). Lier le jeton au principal authentifié, lui donner un TTL court et y inscrire l'identifiant de la requête d'origine relèvent d'un SHOULD. En revanche, si un requestState ne doit être consommé qu'une fois (une validation de paiement, par exemple), l'unicité est à votre charge : « Servers […] MUST enforce that invariant server-side. » (🌐 les serveurs doivent faire respecter cet invariant côté serveur)
Et c'est ici que se trouve le piège opérationnel le plus concret de toute la révision. La documentation du SDK Python le décrit mieux que n'importe quel commentaire :
Sealed under what key? By default, one the server generated with
os.urandom(32)at construction time. Under--workers 4that is four constructions, in four processes: four different keys, never written anywhere, never shared, gone on restart.
🌐 Scellé avec quelle clé ? Par défaut, une clé que le serveur a générée avec os.urandom(32) à sa construction. Sous --workers 4, cela fait quatre constructions dans quatre processus : quatre clés différentes, écrites nulle part, jamais partagées, perdues au redémarrage.
Le symptôme est un -32602 Invalid or expired requestState. Le diagnostic tient en une phrase, et vous la reconnaîtrez si elle vous est déjà arrivée : « A multi-round-trip tool that worked with one worker and started failing some of the time at two is this. » (🌐 un outil multi-tours qui marchait avec un worker et qui se met à échouer par moments avec deux, c'est ça)
Le correctif a deux moitiés, et oublier la seconde suffit à échouer : une clé de scellement partagée entre tous les processus, et un nom de serveur stable, parce qu'il sert de revendication d'audience vérifiée strictement. Nommer ses instances billing-{POD}, ce qui ressemble pourtant à de la bonne hygiène d'observabilité, fait rejeter tous les rejeux inter-instances, clé partagée ou non.
Voilà l'affinité de session revenue par la fenêtre : elle ne porte plus sur la route réseau, mais sur le matériel cryptographique. C'est objectivement mieux (une clé se partage, une session en mémoire non), mais ce n'est pas rien.
Où l'état réapparaît (3) : dans votre infrastructure
Le récit officiel promet des serveurs MCP devenus, selon AWS, « standard HTTPS endpoints, which scale cleanly with enterprise workloads » (🌐 des endpoints HTTPS standards, qui montent en charge proprement avec les charges d'entreprise). C'est vrai pour l'essentiel du trafic. Trois exceptions méritent d'être connues avant de dimensionner quoi que ce soit.
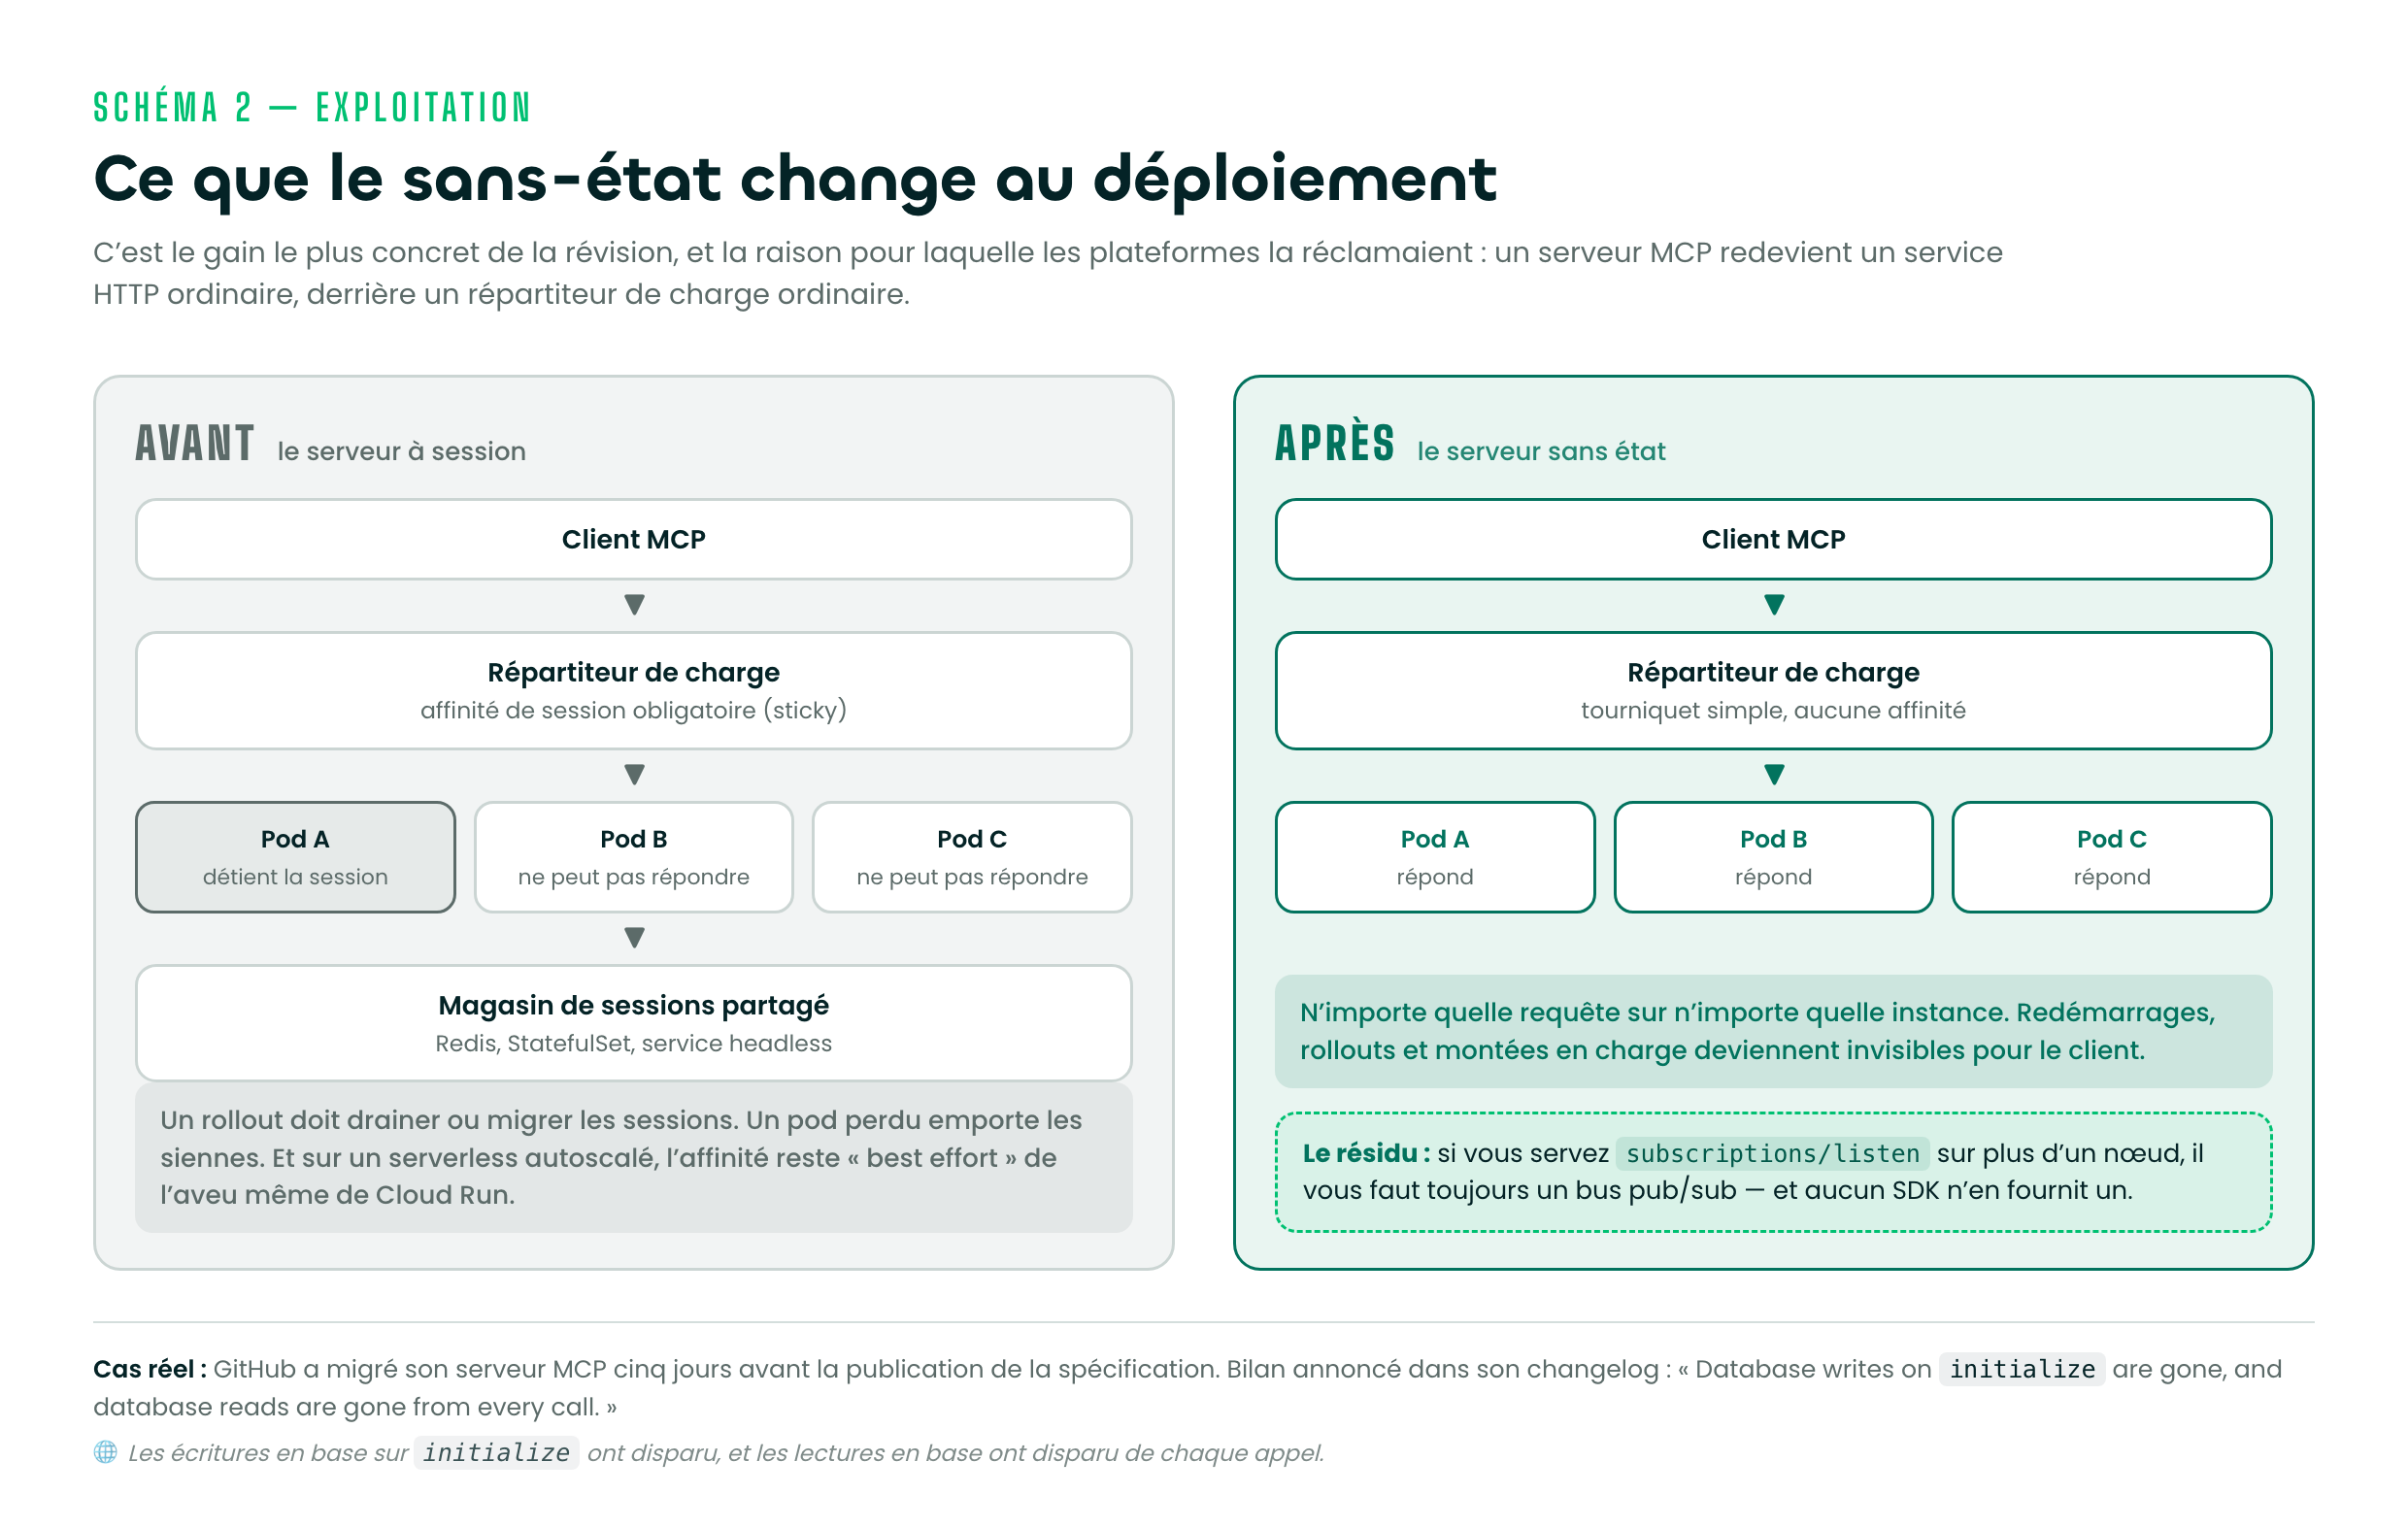
Les flux de notification traversent mal les nœuds. subscriptions/listen est un POST dont la réponse est un flux SSE de longue durée. Sa durée de vie est liée à la requête, pas à la connexion. Mais en pratique, un client abonné est bel et bien attaché à une instance tant que son flux est ouvert. Et surtout, publier un changement depuis un autre nœud ne fonctionne pas tout seul. Le SDK TypeScript est explicite : le bus d'événements par défaut est en mémoire, et « handler.notify.toolsChanged() on node A never reaches a subscriber whose stream node B holds » (🌐 un handler.notify.toolsChanged() sur le nœud A n'atteint jamais un abonné dont le flux est détenu par le nœud B). Le SDK Python est plus direct encore : « Across real processes, the SDK ships no bus that can help you. » (🌐 entre processus réels, le SDK ne fournit aucun bus qui puisse vous aider) À vous d'implémenter l'interface sur Redis, NATS ou ce que vous exploitez déjà. La documentation Python range cela, avec la non-reprise des flux, dans « the two things that being stateless does not buy you » (🌐 les deux choses que le sans-état ne vous offre pas).
Les opérations longues exigent de la durabilité. Les Tasks, sorties du cœur du protocole vers une extension officielle, reposent sur un identifiant durable interrogeable par polling. La règle écrite est : « The task is durably created before the response is sent. » (🌐 la tâche est créée de façon durable avant que la réponse ne soit envoyée) La spécification n'exige pas explicitement un stockage partagé entre réplicas : c'est la conséquence pratique d'un déploiement multi-instances, pas une exigence normative. Mieux vaut le présenter ainsi.
Et parfois, la plateforme réintroduit la session elle-même. Le cas le plus instructif est AWS Bedrock AgentCore Runtime, dont la documentation recommande le mode sans état pour la compatibilité avec l'équilibrage de charge d'AWS… tout en précisant :
Amazon Bedrock AgentCore uses the
Mcp-Session-Idheader to route requests to the same microVM instance. […] Without a consistent session ID, each request may be routed to a new microVM, which may result in additional latency due to cold starts.
🌐 Amazon Bedrock AgentCore utilise l'en-tête Mcp-Session-Id pour router les requêtes vers la même instance de microVM. […] Sans identifiant de session constant, chaque requête peut être routée vers une nouvelle microVM, ce qui peut induire une latence supplémentaire due aux démarrages à froid.
Et : « In both modes, Amazon Bedrock AgentCore always returns an Mcp-Session-Id header to clients. » (🌐 dans les deux modes, Amazon Bedrock AgentCore renvoie toujours un en-tête Mcp-Session-Id aux clients) Le protocole s'est libéré de l'affinité ; l'infrastructure, non. Elle a simplement remonté l'affinité d'un cran, sous forme propriétaire.
Le trou : le rejeu est devenu structurel, l'idempotence n'existe pas
C'est, pour un architecte, le point le plus actionnable de toute la révision, et il est presque absent du discours ambiant.
Additionnez les mécanismes : MRTR rejoue la requête d'origine après collecte des réponses. Un flux de réponse coupé perd la requête en vol, et le client DOIT la réémettre avec un nouvel identifiant. La reprise par Last-Event-ID a disparu, donc chaque redémarrage de pod produit une salve de réémissions. Le rejeu n'est plus un cas dégradé : c'est le fonctionnement normal.
Or, comme le relève l'analyse d'Equixly du 5 août 2026 :
The core protocol defines no idempotency key. Whether that retry duplicates a payment, a deployment, a message, or a deletion depends entirely on whether the tool underneath was written to notice.
🌐 Le protocole de base ne définit aucune clé d'idempotence. Qu'un rejeu duplique un paiement, un déploiement, un message ou une suppression dépend entièrement de la façon dont l'outil sous-jacent a été écrit pour s'en apercevoir.
Le protocole a rendu le rejeu banal sans fournir la primitive qui le rend sûr. Cette responsabilité est intégralement à votre charge, et elle n'est écrite nulle part dans la spécification.
Six règles de conception à appliquer
- Un handle n'est pas une autorisation. Valider le couple (handle, principal authentifié) à chaque appel, en indexant l'état stocké sur l'utilisateur vérifié plutôt que sur la seule valeur fournie par le client. C'est la seule contrainte réellement normative sur les handles.
- Documenter la durée de vie du handle dans la description de l'outil : « returns a
basket_id; baskets expire after 24h idle » (🌐 renvoie unbasket_id; les paniers expirent après 24 h d'inactivité). Renvoyer aussi une erreur d'expiration exploitable, que le modèle puisse lire et corriger de lui-même. Le handle vit dans le contexte du modèle : c'est le modèle qu'il faut informer. - Partager la clé de scellement du
requestStateentre tous les processus, et figer le nom du serveur. Une clé par worker et un nom d'instance variable produisent exactement le même symptôme : un échec intermittent qui apparaît le jour où vous passez à deux réplicas. - Ajouter votre propre clé d'idempotence. Le protocole n'en a pas et le rejeu est devenu la norme. Tout outil non idempotent qui touche à de l'argent, à un déploiement ou à une suppression doit se protéger lui-même.
- Prévoir le bus si vous servez
subscriptions/listensur plus d'un nœud. Aucun SDK ne le fournit. Et rappelez-vous que les flux ne sont ni reprenables ni rejoués : la perte d'un réplica coupe ses flux, les clients se réabonnent et refont leurs lectures. - Garder le chemin legacy, et déployer en canari. L'incompatibilité est bidirectionnelle : un client moderne échoue sur un serveur ancien, et un serveur moderne sur un client ancien. Servir les deux ères sur le même endpoint n'est pas une phase de transition, c'est l'état stable pour un bon moment.
Une septième règle, si vous mettez en cache : les nouveaux champs ttlMs et cacheScope sont obligatoires sur les méthodes de liste, mais la spécification prévient qu'ils ne suffisent pas à protéger l'accès : « Caches MUST NOT be shared across authorization contexts » (🌐 les caches ne doivent pas être partagés entre contextes d'autorisation). Un tools/list authentifié mis en cache en public se partage entre porteurs de jetons différents.
Le regard de Pulse by Astek
Notre lecture : ce n'est ni une révolution, ni une simple formalisation. C'est une correction de trajectoire assumée, exécutée en rupture nette, et dont le bénéfice principal était déjà encaissé par ceux qui n'avaient pas attendu la permission.
Trois conséquences pratiques.
Si vous exploitez un serveur MCP distant bâti sur l'affinité de session, c'est une vraie migration d'architecture, pas une montée de version de SDK. Le changement est incompatible dans les deux sens du fil. La formulation de Victor Dibia est la bonne : « existing servers need real refactors, not a version bump » (🌐 les serveurs existants ont besoin de vrais refactorings, pas d'une montée de version). En revanche, rien ne casse pour l'existant : les mainteneurs sont clairs sur ce point, et les SDK de premier rang ont conservé la compatibilité ascendante.
Si vous concevez un serveur aujourd'hui, concevez-le sans état, mais concevez explicitement où l'état va vivre. C'est la formule la plus juste que nous ayons lue sur cette révision, signée MCPJam : « The complexity does not vanish. It moves to places where developers can see and control it. » (🌐 la complexité ne disparaît pas ; elle se déplace vers des endroits que les développeurs voient et contrôlent) C'est un progrès de conception réel : un handle dans un résultat d'outil est infiniment plus lisible et plus auditable qu'un état caché dans des métadonnées de transport. Mais c'est un déplacement, pas une disparition.
Et gardez la bonne question en tête. Le sans-état a rendu le serveur MCP trivialement scalable. Il se trouve que ce n'était déjà plus la contrainte active. Trois semaines après une spécification qui promet des endpoints HTTPS ordinaires, Microsoft a rendu généralement disponible son serveur MCP distant Azure DevOps, auquel Claude Desktop, Claude Code, ChatGPT et Cursor ne peuvent pas se connecter, parce que Microsoft Entra ID ne prend en charge ni l'enregistrement dynamique de client, ni les Client ID Metadata Documents. Le blocage n'est ni dans le protocole, ni dans les clients : il est dans le fournisseur d'identité.
La feuille de route officielle ne s'y trompe pas, et le constat est cinglant : « MCP authorization assumes a person with a browser at consent time. Increasingly the caller is an agent. » (🌐 l'autorisation MCP présuppose une personne devant un navigateur au moment du consentement ; de plus en plus, l'appelant est un agent)
La vraie question de 2026 n'est plus « comment scaler un serveur MCP ». C'est « comment un agent s'y authentifie ».
Pour aller plus loin
- Le cœur normatif : Base Protocol, révision 2026-07-28 et le changelog de la révision
- Les deux propositions qui ont retiré l'état : SEP-2567, Sessionless MCP et SEP-2575, Stateless MCP
- Le pattern de remplacement : Multi Round-Trip Requests
- Le registre des dépréciations : Deprecated features
- Le point de vue des plateformes : Cloudflare et Google Cloud
- L'angle sécurité : Equixly, « Stateless MCP »