Retour d'expérience sur Genkit
Par ALEXANDRE DERGHAM · 2026-11-09
Développer des applications GenAI complexes exige d'orchestrer agents, RAG et outils externes tout en assurant une forte observabilité. Pour relever ce défi d'architecture, j'ai choisi Genkit (Firebase/Google). Dans cet article, je partage mon retour d'expérience sur la création d'un chatbot complet. Découvrez comment son approche code-first (TypeScript/Zod), ses flows typés et sa Genkit UI simplifient la conception, le débogage et le benchmarking d'applications IA robustes.
Tags : Genkit, Firebase, Firestore, RAG
L’intégration d’IA générative au sein d’applications complexes est rapidement devenue un défi d’architecture logicielle. Au-delà du simple appel à une API de modèle de langage (LLM), la gestion d'applications GenAI concrètes implique la coordination de plusieurs agents, l'injection de contexte via de la recherche documentaire (RAG), la connexion avec des systèmes tiers via des outils (tools), ainsi qu'un besoin fondamental d'observabilité.
Face à ces enjeux, j'ai fait le choix d’utiliser Genkit (développé par l'équipe Firebase / Google). Dans cet article, je partage mon retour d'expérience après avoir construit et déployé une architecture GenAI robuste avec ce framework.
Pourquoi choisir Genkit
Au début, j'ai été confronté à des limites récurrentes liées aux approches purement custom ou à d’autres bibliothèques du marché :
- Manque de typage fort : Passer des données structurées entre plusieurs étapes de chaîne de traitement sans validation d'entrée/sortie entraîne rapidement des bugs silencieux.
- Complexité d'observabilité : Comprendre pourquoi un agent a dévié ou quel tool a échoué dans un enchaînement de 5 appels LLM s’apparente vite à chercher une aiguille dans une botte de foin sans outil de tracing adéquat.
- Outillage dispersé : Gérer séparément le RAG, l'évaluation et l'orchestration rendait le projet difficile à maintenir.
Genkit s'est imposé grâce à sa philosophie code-first, son typage rigoureux basé sur TypeScript et Zod, ainsi que son interface de développement intégrée (Genkit Developer UI).
Description du besoin et structure de notre agent
Le besoin fonctionnel
L'application Genkit que nous allons décrire dans cet article est un chatbot qui doit répondre à l'utilisateur en :
- respectant l'attitude d'un persona ;
- générant une réponse en streaming, pour le confort de l'utilisateur ;
- apportant des réponses correctes, précises et cohérentes en s'appuyant sur une source de données externe ;
- catégorisant la réponse produite.
En entrée, l'application cliente envoie le prompt de l'utilisateur, accompagné d'une configuration qui comporte :
- le persona du chatbot ;
- les tags catégoriels à contrôler, chacun avec la question qui permet de le vérifier.
Structure de l'agent
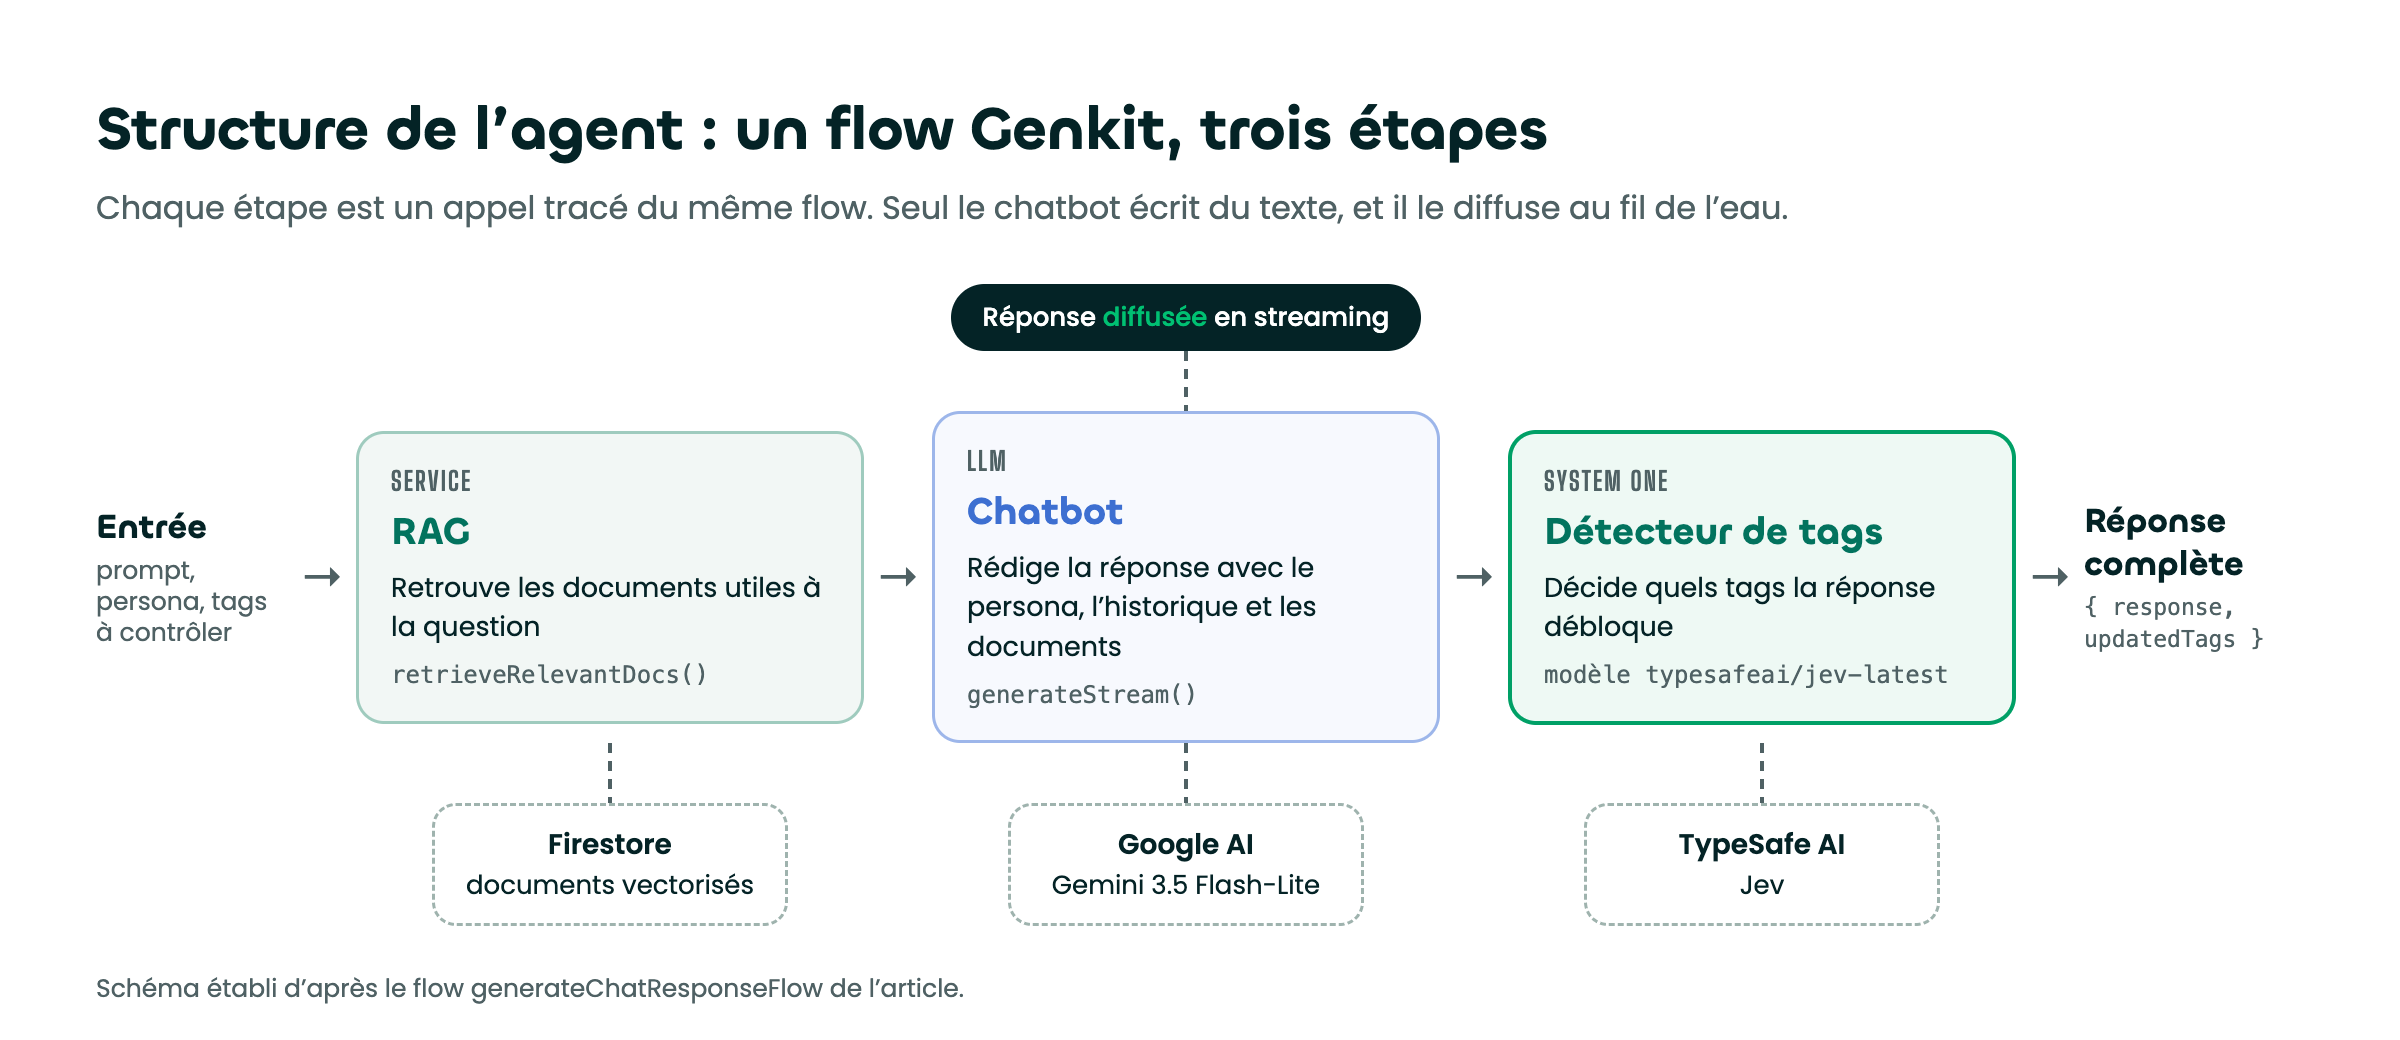
Définition et orchestration d'un flow multi-agents
Le cœur opérationnel de notre application repose sur la notion de Flow dans Genkit. Un flow est une fonction fortement typée qui implémente la logique métier, gère les états et orchestre les différents agents.
Avant d'écrire le flow, définissons les différents agents de notre système.
L'agent de chatbot
import { GenerateOptions } from '@genkit-ai/ai';
import { MessageData, Part } from 'genkit';
import { ChatConfig, ChatSubject } from '../model/chat-subject';

type Message = (MessageData & {
  content: Part[] | string | (string | Part)[];
});

export const generateChatPrompt = (
  // l'entrée envoyée par l'application cliente
  { prompt, config, chatLog }: ChatSubject,

  // les documents sélectionnés par le RAG pour compléter le contexte
  docContext: string[] = []
): GenerateOptions => {
  const baseMessages: Message[] = [
    {
      role: 'user',
      // génère le prompt incluant la config du persona
      // et les documents issus du RAG
      content: [{ text: generateChatSystemPrompt(config, docContext) }]
    },
    {
      role: 'model',
      content: [{ text: config.initText }] // ex: Hello! how can I help you?
    }
  ];

  const chatLogAsMessages: Message[] = chatLog.map(({ text, author }) => ({
    role: author === 'model' ? 'model' : 'user',
    content: [{ text }]
  }));

  return {
    model: 'googleai/gemini-3.5-flash-lite',
    prompt,
    config: {
      temperature: 0.4,
      topP: 0.95
    },
    // le prompt est traité en incluant l'historique de la conversation.
    messages: baseMessages.concat(chatLogAsMessages)
  };
};
Le RAG (Retrieval Augmented Generation)
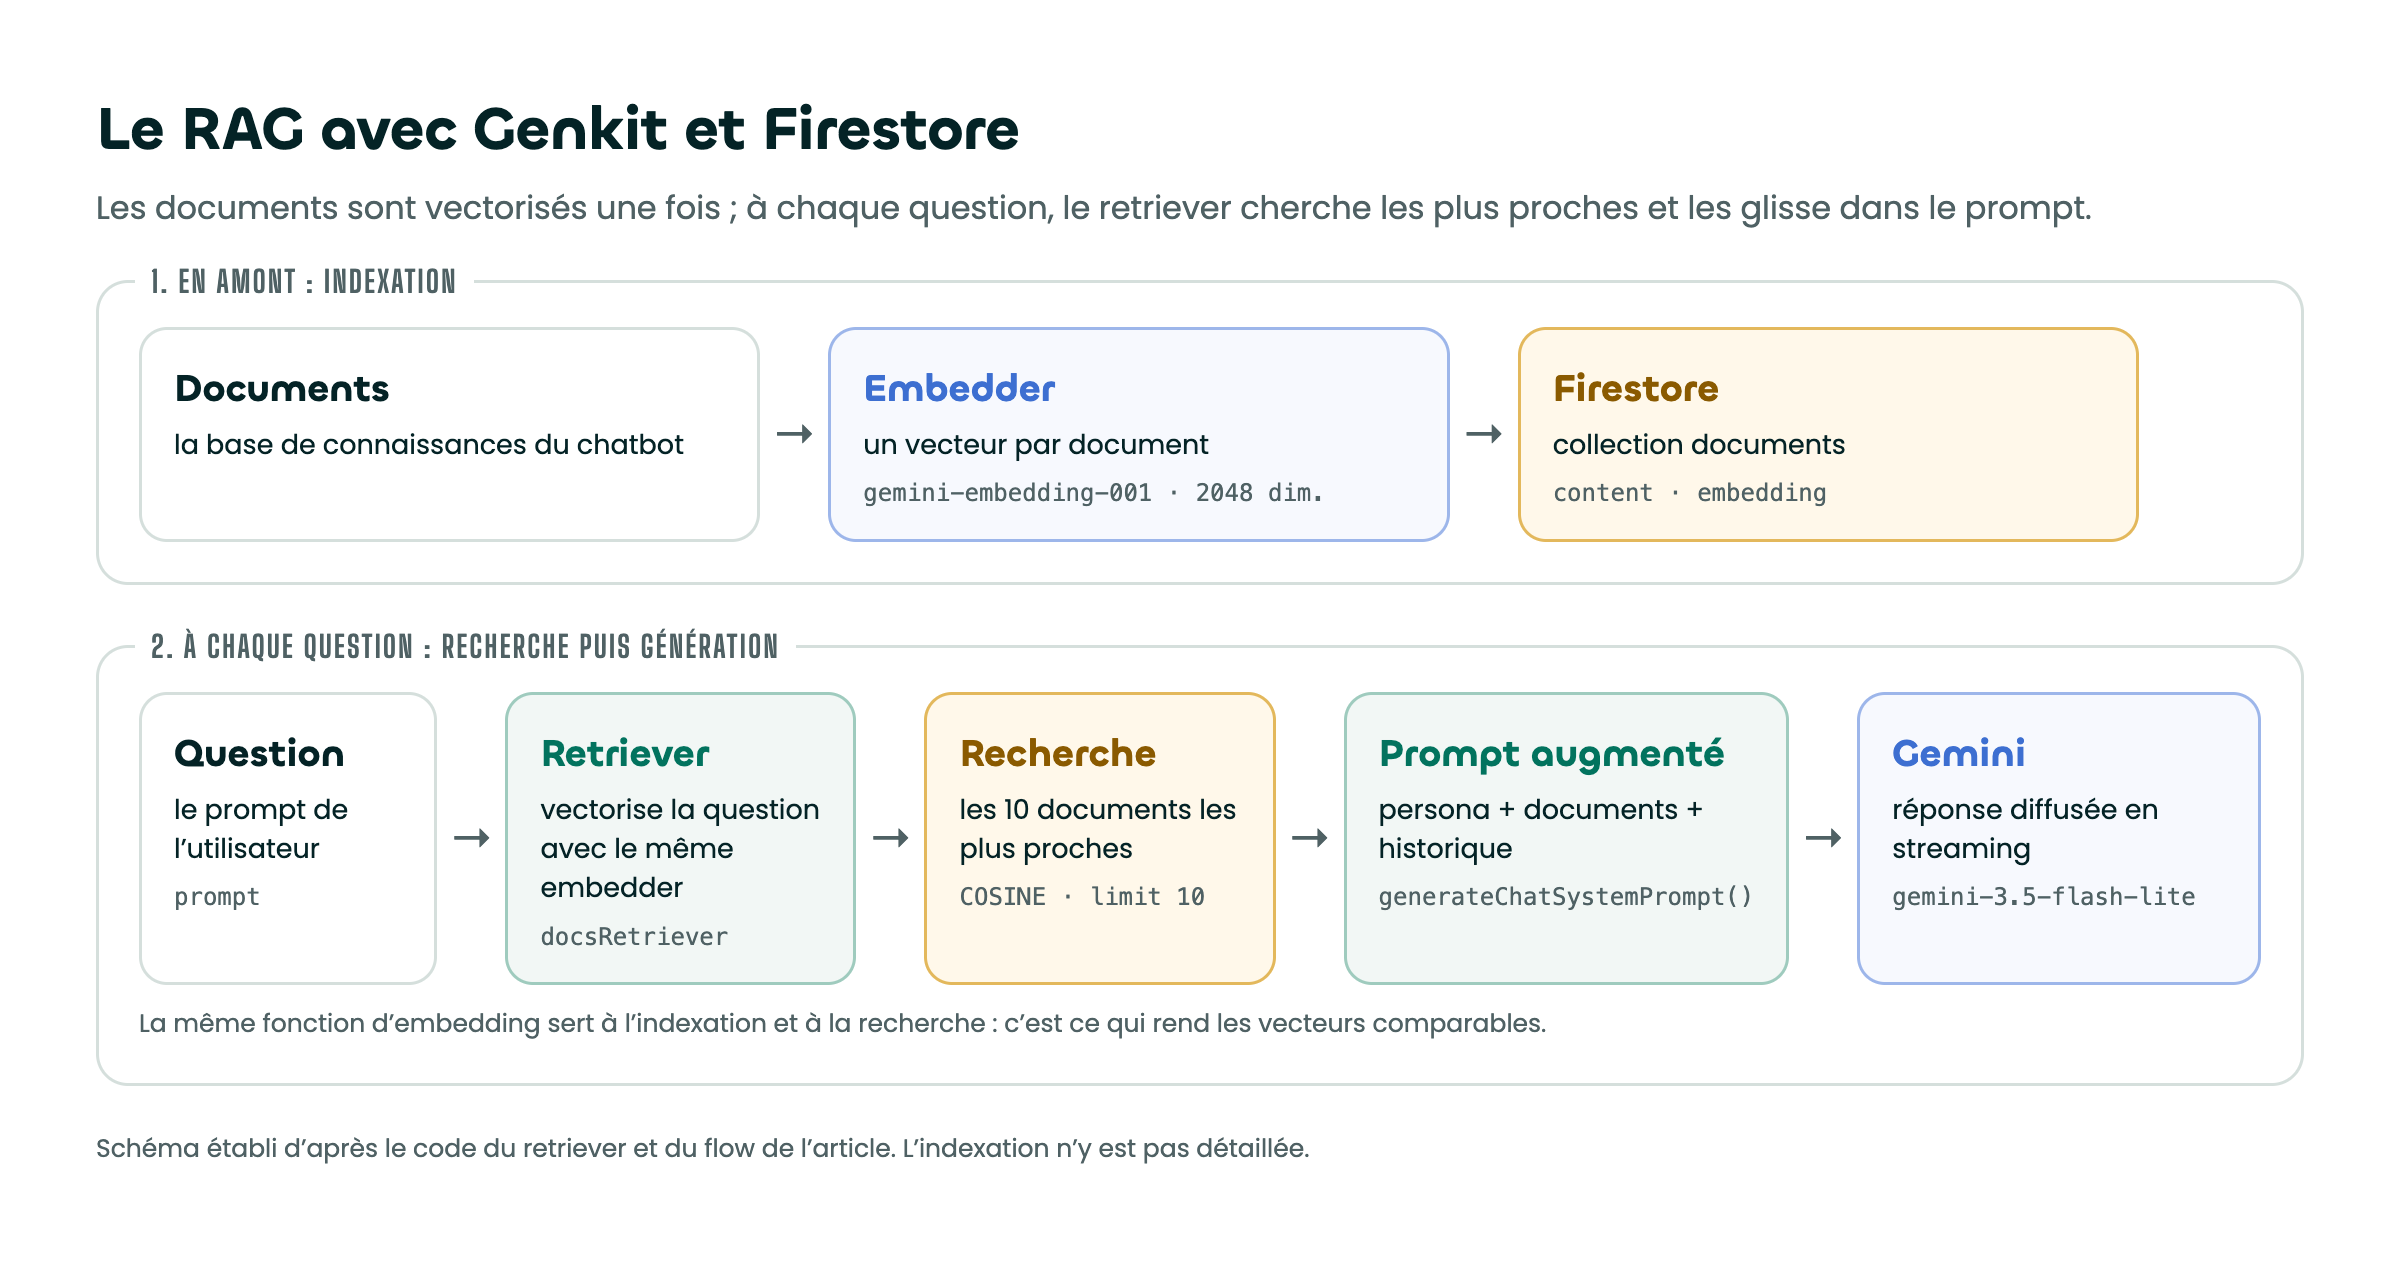
Afin d'améliorer le prompt produit, il est possible de s'appuyer sur des données existantes, stockées dans Firestore et préalablement vectorisées (ou « embeddées »).
On définit pour cela un retriever, qui prend en charge la recherche par similarité de vecteurs.
import { getApps, initializeApp } from 'firebase-admin/app';
import { defineFirestoreRetriever } from '@genkit-ai/firebase';
import { getFirestore, Firestore } from 'firebase-admin/firestore';
import { Genkit } from 'genkit';
import { googleAI } from '@genkit-ai/google-genai';

export const retrieveRelevantDocs = async (
  ai: Genkit,
  prompt: string
): Promise<string[]> => {

  if (!prompt || prompt.length === 0) {
    return [];
  }

  try {
    const db = getFirestoreDb(); // initialise firebase-admin une seule fois (non détaillé ici)

    const retriever = defineFirestoreRetriever(ai, {
      name: 'docsRetriever',
      firestore: db,
      collection: 'documents',
      contentField: 'content',
      vectorField: 'embedding',
      embedder: googleAI.embedder(
        'gemini-embedding-001',
        { outputDimensionality: 2048 }
      ),
      distanceMeasure: 'COSINE',
    });

    const docs = await ai.retrieve({
      retriever,
      query: prompt,
      options: { limit: 10 }
    });

    return docs.flatMap((d) => d.content)
      .map((c) => c.text)
      .filter((t) => t !== undefined);
  } catch (error) {
    console.error('Error retrieving relevant documents:', error);
    return [];
  }
};
Coordination et intégration d'un agent SystemOne (Jev)
Dans ce pipeline, tous les agents ne sont pas gérés nativement par le même modèle ou la même infrastructure. Par exemple, l'agent spécialisé SystemOne (Jev), qui ajoute les tags catégoriels, doit être déclaré comme modèle personnalisé, faute de plugin permettant de l'intégrer.
Cette partie est détaillée dans l'article dédié à l'intégration de Jev dans un agent Genkit.
Le flow
import { googleAI } from '@genkit-ai/google-genai';
import { GenerationCommonConfigSchema, genkit, z } from 'genkit';
import { ChatResponse } from '../model/chat-response';
import { DEFAULT_CHAT_SUBJECT, ChatSubject } from '../model/chat-subject';
import { generateChatPrompt } from '../prompts/chat.prompt';
import { retrieveRelevantDocs } from '../service/doc-retriever.service';
import {
  generateChatResponseUnlockableTagsAnalyserPrompt,
  requestForUnlockableTags
} from '../service/response-analyser.service';

const ai = genkit({
  plugins: [
    googleAI()
  ]
});

// Définition du modèle personnalisé
const typesafeAIModel = ai.defineModel(
  {
    name: 'typesafeai/jev-latest',
    configSchema: GenerationCommonConfigSchema,
    supports: {
      tools: false,
      systemRole: true
    }
  },
  async (request) => {
    return requestForUnlockableTags(request);
  }
);

export const generateChatResponseFlow = ai.defineFlow({
  name: 'generateChatPrompt',
  inputSchema: z.any()
    .describe('A prompt with its configuration')
    .default(DEFAULT_CHAT_SUBJECT),
  outputSchema: z.object({
    response: z.string(),
    updatedTags: z.array(z.string())
  }),
  streamSchema: z.string()
}, async (subject: ChatSubject, { sendChunk }): Promise<ChatResponse> => {
  let relevantDocs: string[] = [];

  const prompt = subject.prompt;

  if (prompt && prompt.trim().length > 0) {
    try {
      // récupération du texte pertinent pour augmenter la génération
      relevantDocs = await retrieveRelevantDocs(ai, prompt);
    } catch (retrievalError) {
      console.warn(
        'Could not compute prompt embedding or retrieve documents:',
        retrievalError
      );
    }
  }

  const chatPrompt = generateChatPrompt(subject, relevantDocs);
  const { response, stream } = ai.generateStream(chatPrompt);

  for await (const chunk of stream) {
    sendChunk(chunk.text);
  }

  const chatResponse = (await response).text;

  const unlockableTags = subject.config.unlockableTags ?? [];
  let updatedTags: string[] = [];
  if (unlockableTags.length > 0) {
    const jevResponse = await ai.generate({
      ...generateChatResponseUnlockableTagsAnalyserPrompt(chatResponse, unlockableTags),
      model: typesafeAIModel
    });
    updatedTags = jevResponse.message?.content[0]?.custom?.updatedTags ?? [];
  }
  return {
    response: chatResponse,
    updatedTags
  };
});
Extension des capacités : la définition de tools sur mesure
Les modèles de langage gagnent en valeur dès qu'on leur donne la capacité d'agir sur leur environnement. Dans Genkit, la définition d'un tool (outil de Function Calling) est native et totalement typée grâce à Zod.
import { z } from 'genkit';

// ai : l'instance genkit() déclarée avec le flow
export const fetchCustomerData = ai.defineTool(
  {
    name: 'fetchCustomerData',
    description: 'Récupère les informations d\'un client à partir de son ID.',
    inputSchema: z.object({ customerId: z.string() }),
    outputSchema: z.object({ name: z.string(), status: z.string() }),
  },
  async (input) => {
    // Appel d'API interne ou requête en base de données
    return await db.customers.find(input.customerId);
  }
);
En fournissant ces tools au modèle par l'option tools de generate(), l'agent décide en toute autonomie quand exécuter un outil et avec quels paramètres, tout en assurant une validation stricte des arguments d'entrée avant l'exécution du code.
Il est bien évidemment possible de consommer un serveur MCP existant, et même d'en créer et d'en déployer un.
Developer Experience : Traces et Benchmarks
L'un des arguments majeurs en faveur de Genkit réside dans l'outillage de développement fourni hors de la boîte via la Genkit UI.
Observer l'invisible avec l'onglet « Traces »
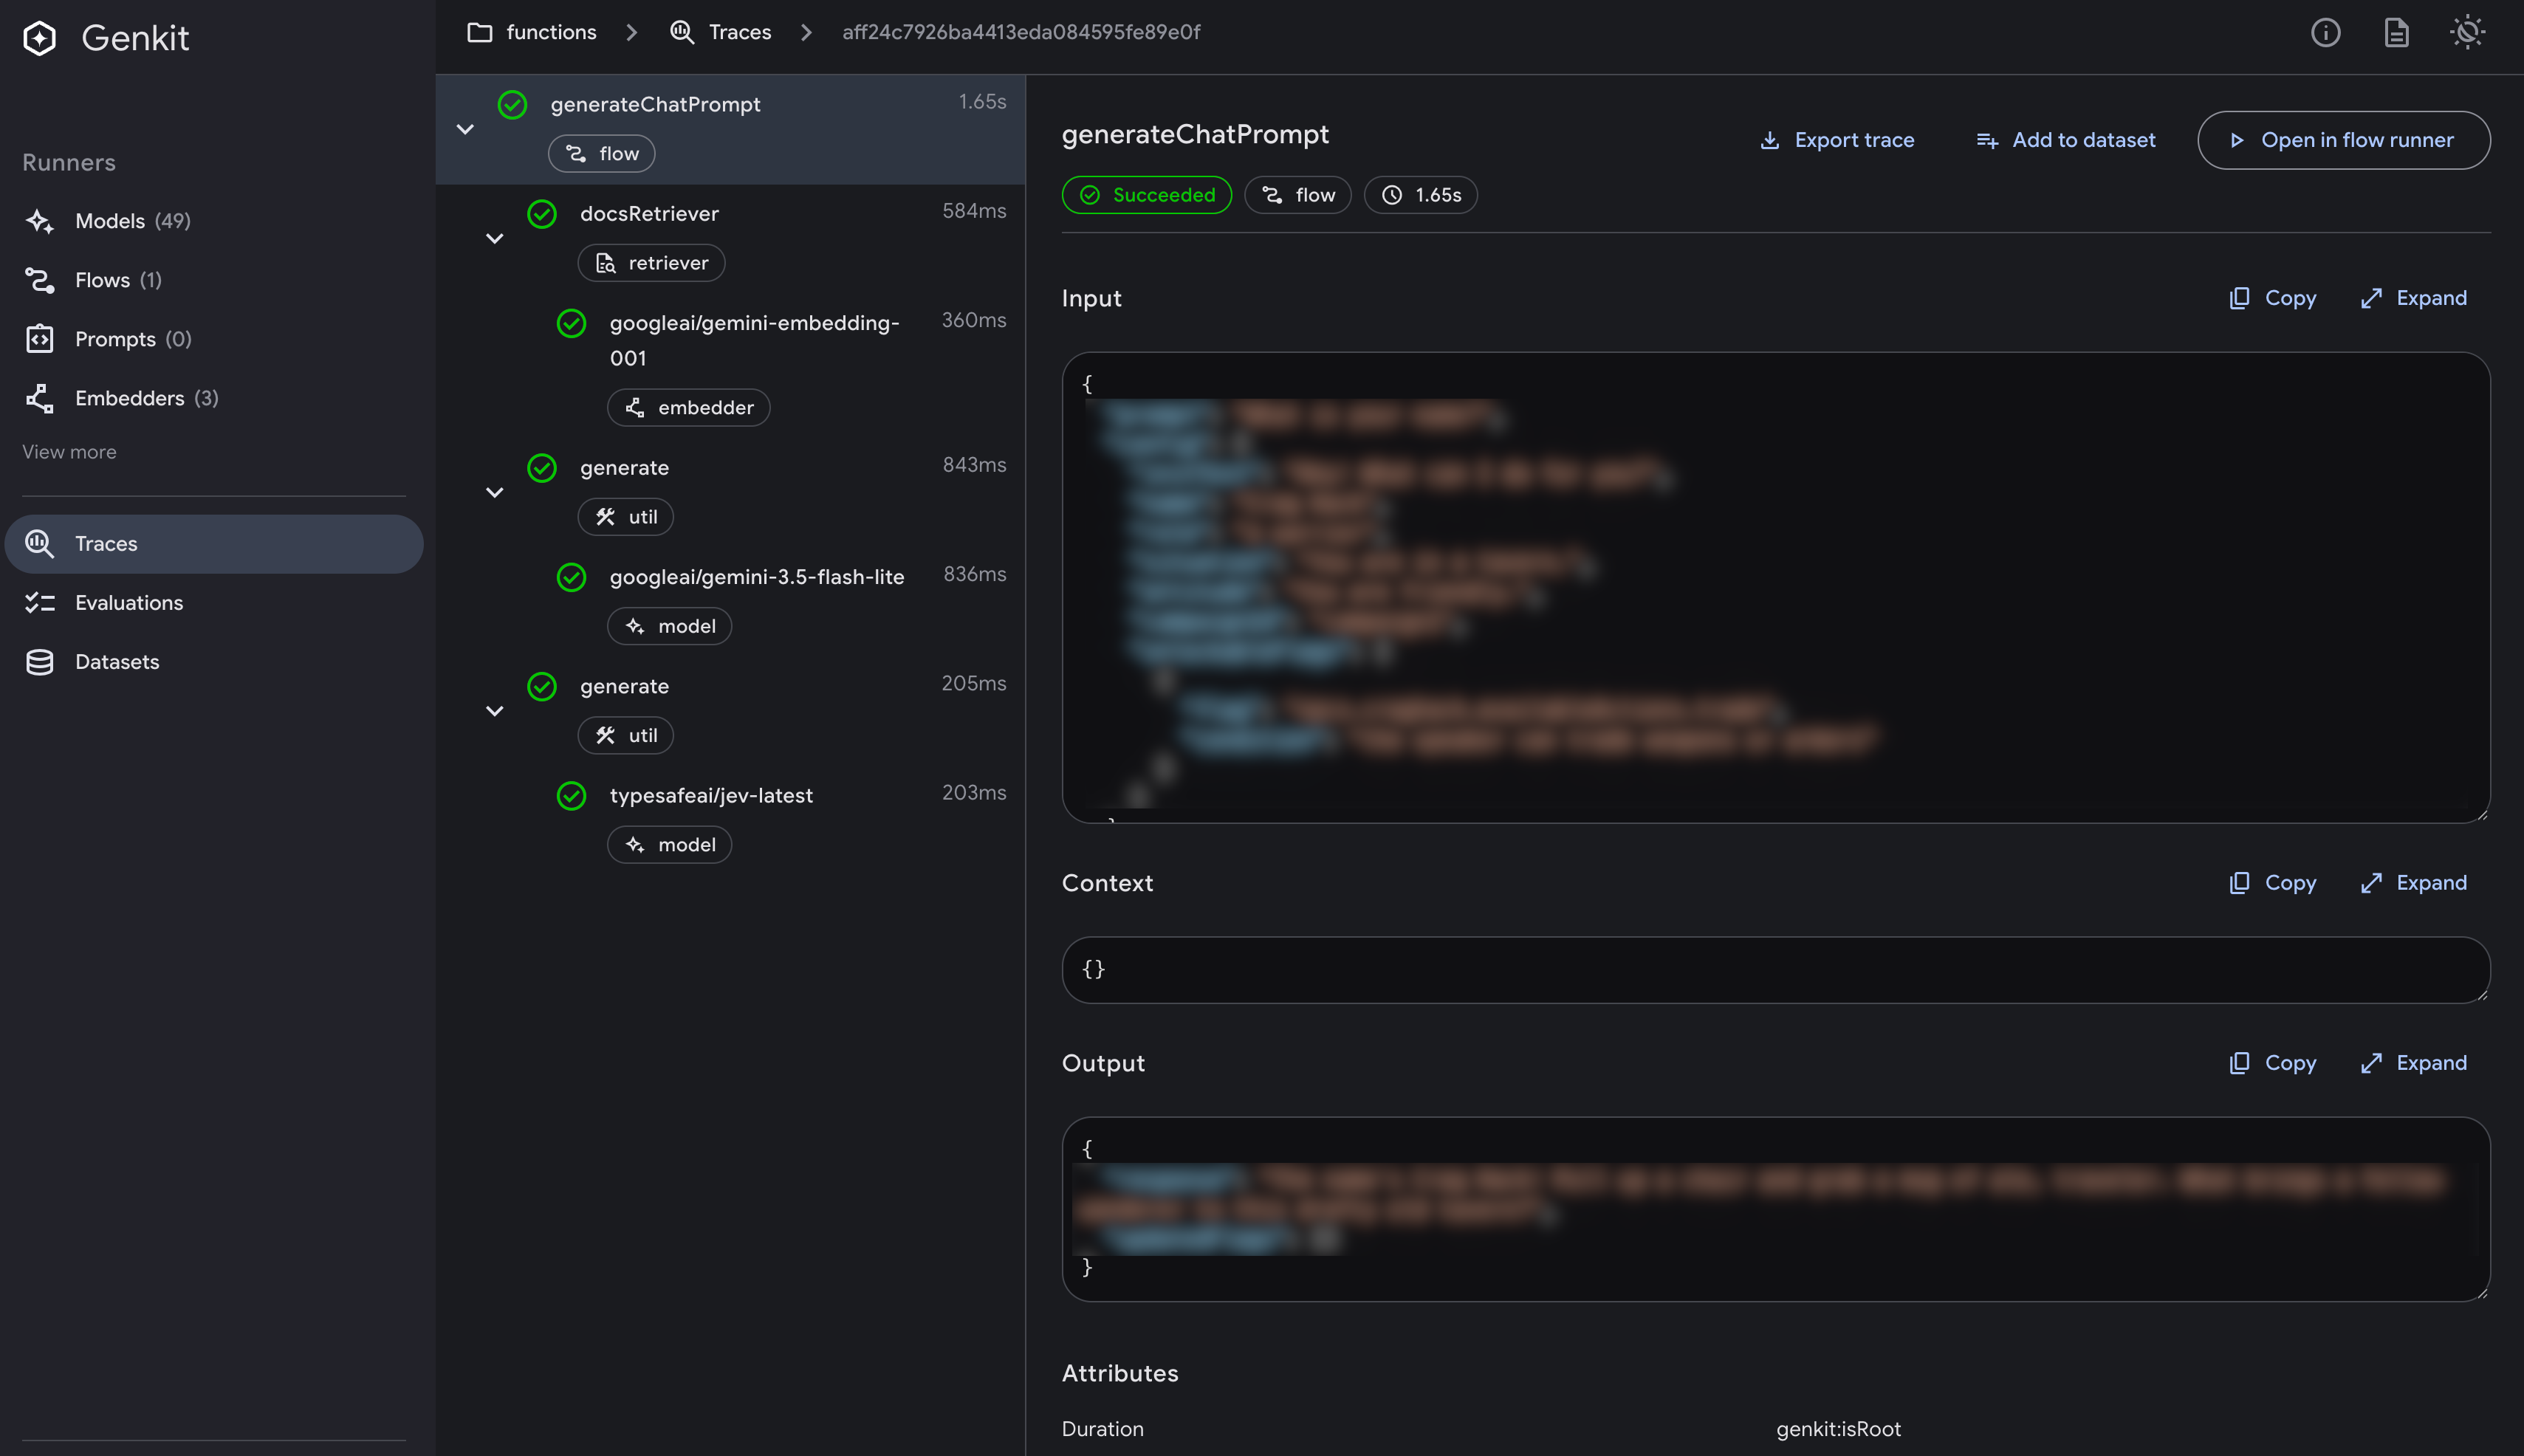
En lançant l'application à travers la CLI Genkit (par exemple npx genkit start -- npx tsx --watch src/index.ts), on accède à une interface locale permettant de visualiser l'exécution complète d'un flow en temps réel :
- Graphe d'exécution : Visualisation de la hiérarchie entre le flow principal, les sous-agents (notamment SystemOne / Jev), les requêtes RAG et l'exécution des tools.
- Inspection des payloads : Lecture directe des prompts envoyés aux LLMs, des réponses brutes, du nombre de tokens consommés et de la latence de chaque étape.
- Debug granulaire : Identification immédiate d'un tool ayant renvoyé une erreur ou d'un prompt mal interprété.
Benchmarker et évaluer sans deviner
Plutôt que d'évaluer la qualité de nos agents au ressenti, il est possible de tirer parti des fonctionnalités de benchmarking et d'évaluation de Genkit.
- Définition de jeux de données d'évaluation (Datasets) : Création de cas de tests d'entrée/sortie attendues.
- Exécution des évaluateurs : Utilisation d'évaluateurs intégrés (fidélité au contexte, pertinence, détection d'hallucinations).
- Comparaison de modèles : Exécution du même flow en faisant varier le modèle sous-jacent (par exemple Gemini Pro vs Gemini Flash).
Cette approche méthodique permet d'arbitrer objectivement le compromis entre coût, vitesse de réponse et qualité de génération avant déploiement de l'agent.
Bilan et perspectives : notre avis sur Genkit
Ce que nous avons aimé
- Typage et fiabilité : La combinaison TypeScript + Zod élimine une classe entière de bugs. Cette solution garantit le format de sortie des agents.
- Observabilité : L'onglet Traces de Genkit UI fait gagner un temps précieux lors des phases de debug et de réglage fin des prompts.
- Écosystème cohérent et complet : RAG, Tools, MCP, Flows et Évaluation regroupés sous une architecture uniforme. Genkit comporte des plugins permettant de s'interfacer avec les principaux modèles du marché (Anthropic, OpenAI, etc.) et de se connecter à des sources de données externes (Neo4j, Firestore, etc.).
Points de vigilance
- Écosystème en évolution : Le framework évolue rapidement ; il convient de suivre régulièrement les mises à jour des API et des plugins.
- Nouvelle API d'agents : à surveiller en particulier, la nouvelle API de définition d'agents (encore en bêta au moment où cet article est écrit) propose une approche plus moderne de leur écriture.
Conclusion
Genkit s’est révélé être un outil intéressant pour concevoir et déployer des workflows multi-agents robustes de manière intuitive et cohérente, en particulier dans un environnement Google Firebase.
Nous le recommandons si vous cherchez un framework orienté backend pour écrire des agents en TypeScript, Go, Dart ou Python (prochainement), avec un outillage qui facilite les tests et le débogage.
Le framework est activement maintenu, il continue d'évoluer et son écosystème s'étend.
Pour aller plus loin
- Le site officiel de Genkit
- La documentation de l'API Gemini (Google AI Studio)
- La documentation de Typesafe AI
- L'article détaillant l'intégration de Jev